
Latający premierzy
Przełom lipca i sierpnia 2019 roku w polskiej polityce zdominowany był przez informacje o lotach - najpierw marszałka Sejmu, później kolejnych premierów. KPRM opublikował listę lotów kolejnych premierów z ostatnich kilku lat - zobaczmy czego nie zrobiły z nią media?
Listy te (na dzień 18 sierpnia 2019 roku) dostępne były pod linkami:
Nie znalazłem w żadnych mediach sensownego porównania pomiędzy premierami, więc porównam sobie sam. Przy okazji pokazując jak można w kilkadziesiąt minut przygotować rzetelny materiał.
Jeśli chcesz zobaczyć wynik analizy - przejdź niżej.
Przygotowanie danych
W pierwszej kolejności pobieramy pliki PDF (z powyżej podanych adresów). Drugi element to przepisanie danych do analizowanej postaci. Do wczytania PDFów w R można wykorzystać pakiet pdftools.
Pakiet ten wskazany plik czyta i zwraca jako listę z zawartością poszczególnych stron. Każdy z elementów tej listy to zwykły ciąg znaków. Na szczęście w tych dokumentach mamy do czynienia z jednakowymi tabelkami - możemy więc każdy z plików potraktować jednakowo. Poniższy kod zrobi za nas część pracy:
library(tidyverse)
library(pdftools)

# lista plików PDF
file_names <- c("dane/pbs.pdf", "dane/pdt.pdf", "dane/pek.pdf", "dane/pmm.pdf")

# tutaj będziemy trzymać pełne dane
complete = c()

# dla każdego kolejnego pliku:
for(file_name in file_names) {
  # wczytujemy PDFa
  pdf <- pdf_text(file_name)

  # miejsce na linie z aktualnie przerabianego pliku
  full <- c()

  # dla każdej ze stron w pliku
  for(i in 1:length(pdf)) {
    # dzielimy stronę na linie
    temp <- str_split(pdf[i], "\n")[[1]]
    # dodajemy linie z bierzącej strony do linii z całego pliku
    full <- c(full, temp)
  }

  # usuwamy puste linie
  full <- full[nchar(full) != 0]

  # więcej niż jedna spacja zostaje zamieniona na ;
  full <- gsub(pattern = " +", ";", full)

  # dodajemy kolumnę z nazwą pliku
  full <- paste0(full, ";", file_name)

  # dodajemy linie pliku do pełnych danych
  complete <- c(complete, full)
}

# zapisujemy pełne dane do pliku CSV
write_lines(complete, "dane/zapis.csv")
Teraz trochę ręcznej gimnastyki. Otwieramy zapisany plik CSV w Excelu i oglądamy każdy z wierszy. Docelowo chcemy uzyskać postać tabeli, gdzie każdy wiersz będzie zwierał trzy kolumny:
- kolumna data - data w formacie dzień.miesiąc.rok (tak jak to zapisane w dokumentach)
- kolumna trasa - trasę jaką przebył samolot w formacie lotnisko A-lotnisko B-lotnisko C; ważne żeby kolejne lotniska rozdzielone były myślnikami
- kolumna kto - nazwę pliku z jakiego pochodzi informacja - to opisuje nam z którym premierem mamy do czynienia
Wierszy było około tysiąca, ich poprawa zajęła może z 30 minut polegających głównie na złączeniu tekstów z dwóch (czasem więcej) kolumn do jednej komórki i ewentualnym przesunięciu wiersza w prawo. Niektóre wiersze trzeba było też usunąć (nagłówki tabel). Zapewne udałoby się to zrobić z poziomu R (i odpowiednich wyrażeń regularnych - tutaj sprawdzą się znakomicie), ale ręczny przegląd danych czasem też się przydaje.
Kolejny krok to oczyszczenie danych. Lotniska nazwane są kodami, ale czasem to samo lotnisko występuje pod dwoma różnymi kodami. Maszyna tego nie zrozumie, trzeba jej pomóc.
Przydatne będą dane o lokalizacji lotnisk - znajdziemy je na stronie ourairports.com. Pobieramy plik CSV z listą lotnisk (np. dla całej Europy).
Teraz czas na poprawę i oczyszczenie danych. Najpierw zobaczymy czego nam brakuje i co trzeba poprawić. Wczytujemy plik z listą lotów i rozbijamy kolumnę z trasą samolotu z danego dnia na poszczególne lotniska:
library(tidyverse)

# poprawnione ręcznie dane
df <- read_csv2("dane/zapis.csv")

# położenie lotnisk z http://ourairports.com/
lotniska <- read_csv("dane/airports.csv")

# przygotowanie danych
loty <- df %>%
  # rozdzielenie tracy na kolejne lotniska
  mutate(trasa = str_split(trasa, "-")) %>%
  unnest(trasa)
w tabeli loty mamy teraz kolumnę trasa, która zwiera wszystkie kody lotnisk. Jeśli zrobimy
count(loty, trasa, sort = TRUE)
dostaniemy listę ułożoną wg popularności. Na początku będzie zapewne Warszawa, Gdańsk, Kraków. Warszawa może być jako EPWA lub WAW. W pliku z ourairports.com mamy tylko EPWA - stąd potrzebne korekty (najlepiej od razu na pliku zapis.csv). Jak znaleźć wszystkie lotniska, które trzeba poprawić? Ano próbujemy złączyć tabelkę o lotach z tabelką o lotniskach - to co nie uda się połączyć trzeba poprawić. Łączymy na przykład tak:
loty %>%
  distinct(trasa) %>%
  left_join(lotniska %>% select(ident, name),
            by = c("trasa" = "ident"))
To co w kolumnie name będzie mieć NA to braki. Dla tych wierszy szukamy kodu lotniska (jaki mamy) na stronie ourairports.com i przez search & replace zmieniamy w pliku zapis.csv jeden kod na taki, który podaje ourairports.com. W większości przypadków powinno się udać.
Po zmianach oczywiście zapisujemy zapis.csv.
Z tak poprawionym plikiem robimy porządek w danych doprowadzając je do postaci, gdzie w jednym wierszu będziemy mieć informacje o konkretnym locie, w konkretnym dniu, konkretnego premiera, z jednego do drugiego lotniska:
library(tidyverse)
library(lubridate)

# poprawnione ręcznie dane
df <- read_csv2("dane/zapis.csv")

# położenie lotnisk z http://ourairports.com/
lotniska <- read_csv("dane/airports.csv")

# przygotowanie danych
loty <- df %>%
  # rozdzielenie tracy na kolejne lotniska
  mutate(trasa = str_split(trasa, "-")) %>%
  unnest(trasa) %>%
  select(data, kto, lotnisko_z=trasa) %>%
  # przesuwamy o jeden lotniska
  group_by(kto, data) %>%
  mutate(lotnisko_do = lead(lotnisko_z)) %>%
  filter(!is.na(lotnisko_do)) %>%
  filter(lotnisko_do != lotnisko_z) %>%
  ungroup() %>%
  # dodajemy położenie dla lotniska źródłowego i docelowego
  left_join(lotniska %>%
              select(ident, lat_z=latitude_deg, long_z=longitude_deg, miasto_z=municipality),
            by = c("lotnisko_z" = "ident")) %>%
  left_join(lotniska %>%
              select(ident, lat_do=latitude_deg, long_do=longitude_deg, miasto_do=municipality),
            by = c("lotnisko_do" = "ident")) %>%
  # wybieramy potrzebne kolumny
  select(kto, data, lotnisko_z, lotnisko_do, lat_z, long_z, miasto_z, lat_do, long_do, miasto_do) %>%
  # usuwamy niedopasowane lotniska - uwaga: tracimy część danych!
  na.omit() %>%
  # budujemy trasę przelotu
  mutate(lot = paste0(miasto_z, " - ", miasto_do)) %>%
  # poprawiamy format daty
  rowwise() %>%
  mutate(data2 = str_match(data, "(\\d{2}\\.\\d{2}\\.\\d{4})")[[1,1]] %>% dmy()) %>%
  ungroup() %>%
  mutate(kto = toupper(kto))
Przykładowe wiersze wyglądają następująco:
| kto | data | lotnisko_z | lotnisko_do | lat_z | long_z | miasto_z | lat_do | long_do | miasto_do | lot | data2 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| PMM | 18.03.2019 | EPKK | EPWA | 50.07770 | 19.78480 | Kraków | 52.1657 | 20.96710 | Warsaw | Kraków - Warsaw | 2019-03-18 |
| PDT | 01.12.2008 | EPPO | EPWA | 52.42100 | 16.82630 | Poznań | 52.1657 | 20.96710 | Warsaw | Poznań - Warsaw | 2008-12-01 |
| PBS | 29-30.11.2015 | EPWA | EBBR | 52.16570 | 20.96710 | Warsaw | 50.9014 | 4.48444 | Brussels | Warsaw - Brussels | 2015-11-30 |
| PMM | 16.12.2018 | EPKT | EPWA | 50.47430 | 19.08000 | Katowice | 52.1657 | 20.96710 | Warsaw | Katowice - Warsaw | 2018-12-16 |
| PDT | 27.08.2011 | EPWA | EPWR | 52.16570 | 20.96710 | Warsaw | 51.1027 | 16.88580 | Wrocław | Warsaw - Wrocław | 2011-08-27 |
| PEK | 15.10.2015 | EBBR | EPWA | 50.90140 | 4.48444 | Brussels | 52.1657 | 20.96710 | Warsaw | Brussels - Warsaw | 2015-10-15 |
| PEK | 03.09.2015 | EPWA | EPKT | 52.16570 | 20.96710 | Warsaw | 50.4743 | 19.08000 | Katowice | Warsaw - Katowice | 2015-09-03 |
| PMM | 28.04.2018 | EPZG | EPOK | 52.13850 | 15.79860 | Babimost | 54.5797 | 18.51720 | Gdynia | Babimost - Gdynia | 2018-04-28 |
| PMM | 26.04.2019 | LUZ | EPWA | 51.24028 | 22.71361 | Lublin | 52.1657 | 20.96710 | Warsaw | Lublin - Warsaw | 2019-04-26 |
| PMM | 09.02.2019 | EPRZ | EPWA | 50.11000 | 22.01900 | Rzeszów | 52.1657 | 20.96710 | Warsaw | Rzeszów - Warsaw | 2019-02-09 |
Dane są przygotowane, można przejść do opracowania materiału tak, jak nie zrobiły tego media.
Analiza
Na przykład - najpopularniejsze trasy (3/4 wszystkich dla każdego z premierów):
loty %>%
  count(kto, lot) %>%
  group_by(kto) %>%
  mutate(total = sum(n)) %>%
  ungroup() %>%
  mutate(procent_lotow = 100*n/total) %>%
  arrange(kto, desc(procent_lotow)) %>%
  group_by(kto) %>%
  mutate(total = cumsum(procent_lotow)) %>%
  filter(total <= 75) %>%
  ungroup()
Premier Donald Tusk:
| Trasa lotu | Liczba lotów | % lotów premiera | % skumulowany |
|---|---|---|---|
| Warsaw - Gdańsk | 207 | 27.97 | 27.97 |
| Gdańsk - Warsaw | 165 | 22.30 | 50.27 |
| Brussels - Warsaw | 45 | 6.08 | 56.35 |
| Warsaw - Brussels | 43 | 5.81 | 62.16 |
| Warsaw - Kraków | 26 | 3.51 | 65.68 |
| Katowice - Warsaw | 20 | 2.70 | 68.38 |
| Kraków - Warsaw | 17 | 2.30 | 70.68 |
| Warsaw - Katowice | 13 | 1.76 | 72.43 |
| Warsaw - Wrocław | 13 | 1.76 | 74.19 |
Premier Ewa Kopacz:
| Trasa lotu | Liczba lotów | % lotów premiera | % skumulowany |
|---|---|---|---|
| Brussels - Warsaw | 10 | 13.33 | 13.33 |
| Warsaw - Brussels | 10 | 13.33 | 26.67 |
| Katowice - Warsaw | 7 | 9.33 | 36.00 |
| Warsaw - Katowice | 6 | 8.00 | 44.00 |
| Warsaw - Gdańsk | 4 | 5.33 | 49.33 |
| Wrocław - Warsaw | 4 | 5.33 | 54.67 |
| Gdańsk - Warsaw | 3 | 4.00 | 58.67 |
| Paris - Warsaw | 3 | 4.00 | 62.67 |
| Prague - Warsaw | 3 | 4.00 | 66.67 |
| Warsaw - Wrocław | 3 | 4.00 | 70.67 |
| Kraków - Warsaw | 2 | 2.67 | 73.33 |
Premier Beata Szydło:
| Trasa lotu | Liczba lotów | % lotów premiera | % skumulowany |
|---|---|---|---|
| Kraków - Warsaw | 54 | 27.0 | 27.0 |
| Warsaw - Kraków | 42 | 21.0 | 48.0 |
| Warsaw - Brussels | 13 | 6.5 | 54.5 |
| Warsaw - Katowice | 8 | 4.0 | 58.5 |
| Rzeszów - Warsaw | 7 | 3.5 | 62.0 |
| Brussels - Kraków | 6 | 3.0 | 65.0 |
| Brussels - Warsaw | 5 | 2.5 | 67.5 |
| Warsaw - Rzeszów | 5 | 2.5 | 70.0 |
| Budapest - Warsaw | 4 | 2.0 | 72.0 |
| Katowice - Warsaw | 4 | 2.0 | 74.0 |
Premier Mateusz Morawiecki:
| Trasa lotu | Liczba lotów | % lotów premiera | % skumulowany |
|---|---|---|---|
| Kraków - Warsaw | 29 | 8.95 | 8.95 |
| Warsaw - Kraków | 21 | 6.48 | 15.43 |
| Wrocław - Warsaw | 19 | 5.86 | 21.30 |
| Warsaw - Katowice | 17 | 5.25 | 26.54 |
| Katowice - Warsaw | 16 | 4.94 | 31.48 |
| Warsaw - Brussels | 15 | 4.63 | 36.11 |
| Warsaw - Wrocław | 15 | 4.63 | 40.74 |
| Brussels - Warsaw | 13 | 4.01 | 44.75 |
| Rzeszów - Warsaw | 12 | 3.70 | 48.46 |
| Warsaw - Gdańsk | 11 | 3.40 | 51.85 |
| Warsaw - Rzeszów | 11 | 3.40 | 55.25 |
| Gdańsk - Warsaw | 9 | 2.78 | 58.02 |
| Gdynia - Warsaw | 9 | 2.78 | 60.80 |
| Warsaw - Gdynia | 8 | 2.47 | 63.27 |
| Warsaw - Goleniow | 8 | 2.47 | 65.74 |
| Warsaw - Poznań | 8 | 2.47 | 68.21 |
| Goleniow - Warsaw | 7 | 2.16 | 70.37 |
| Lublin - Warsaw | 6 | 1.85 | 72.22 |
| Warsaw - Lublin | 6 | 1.85 | 74.07 |
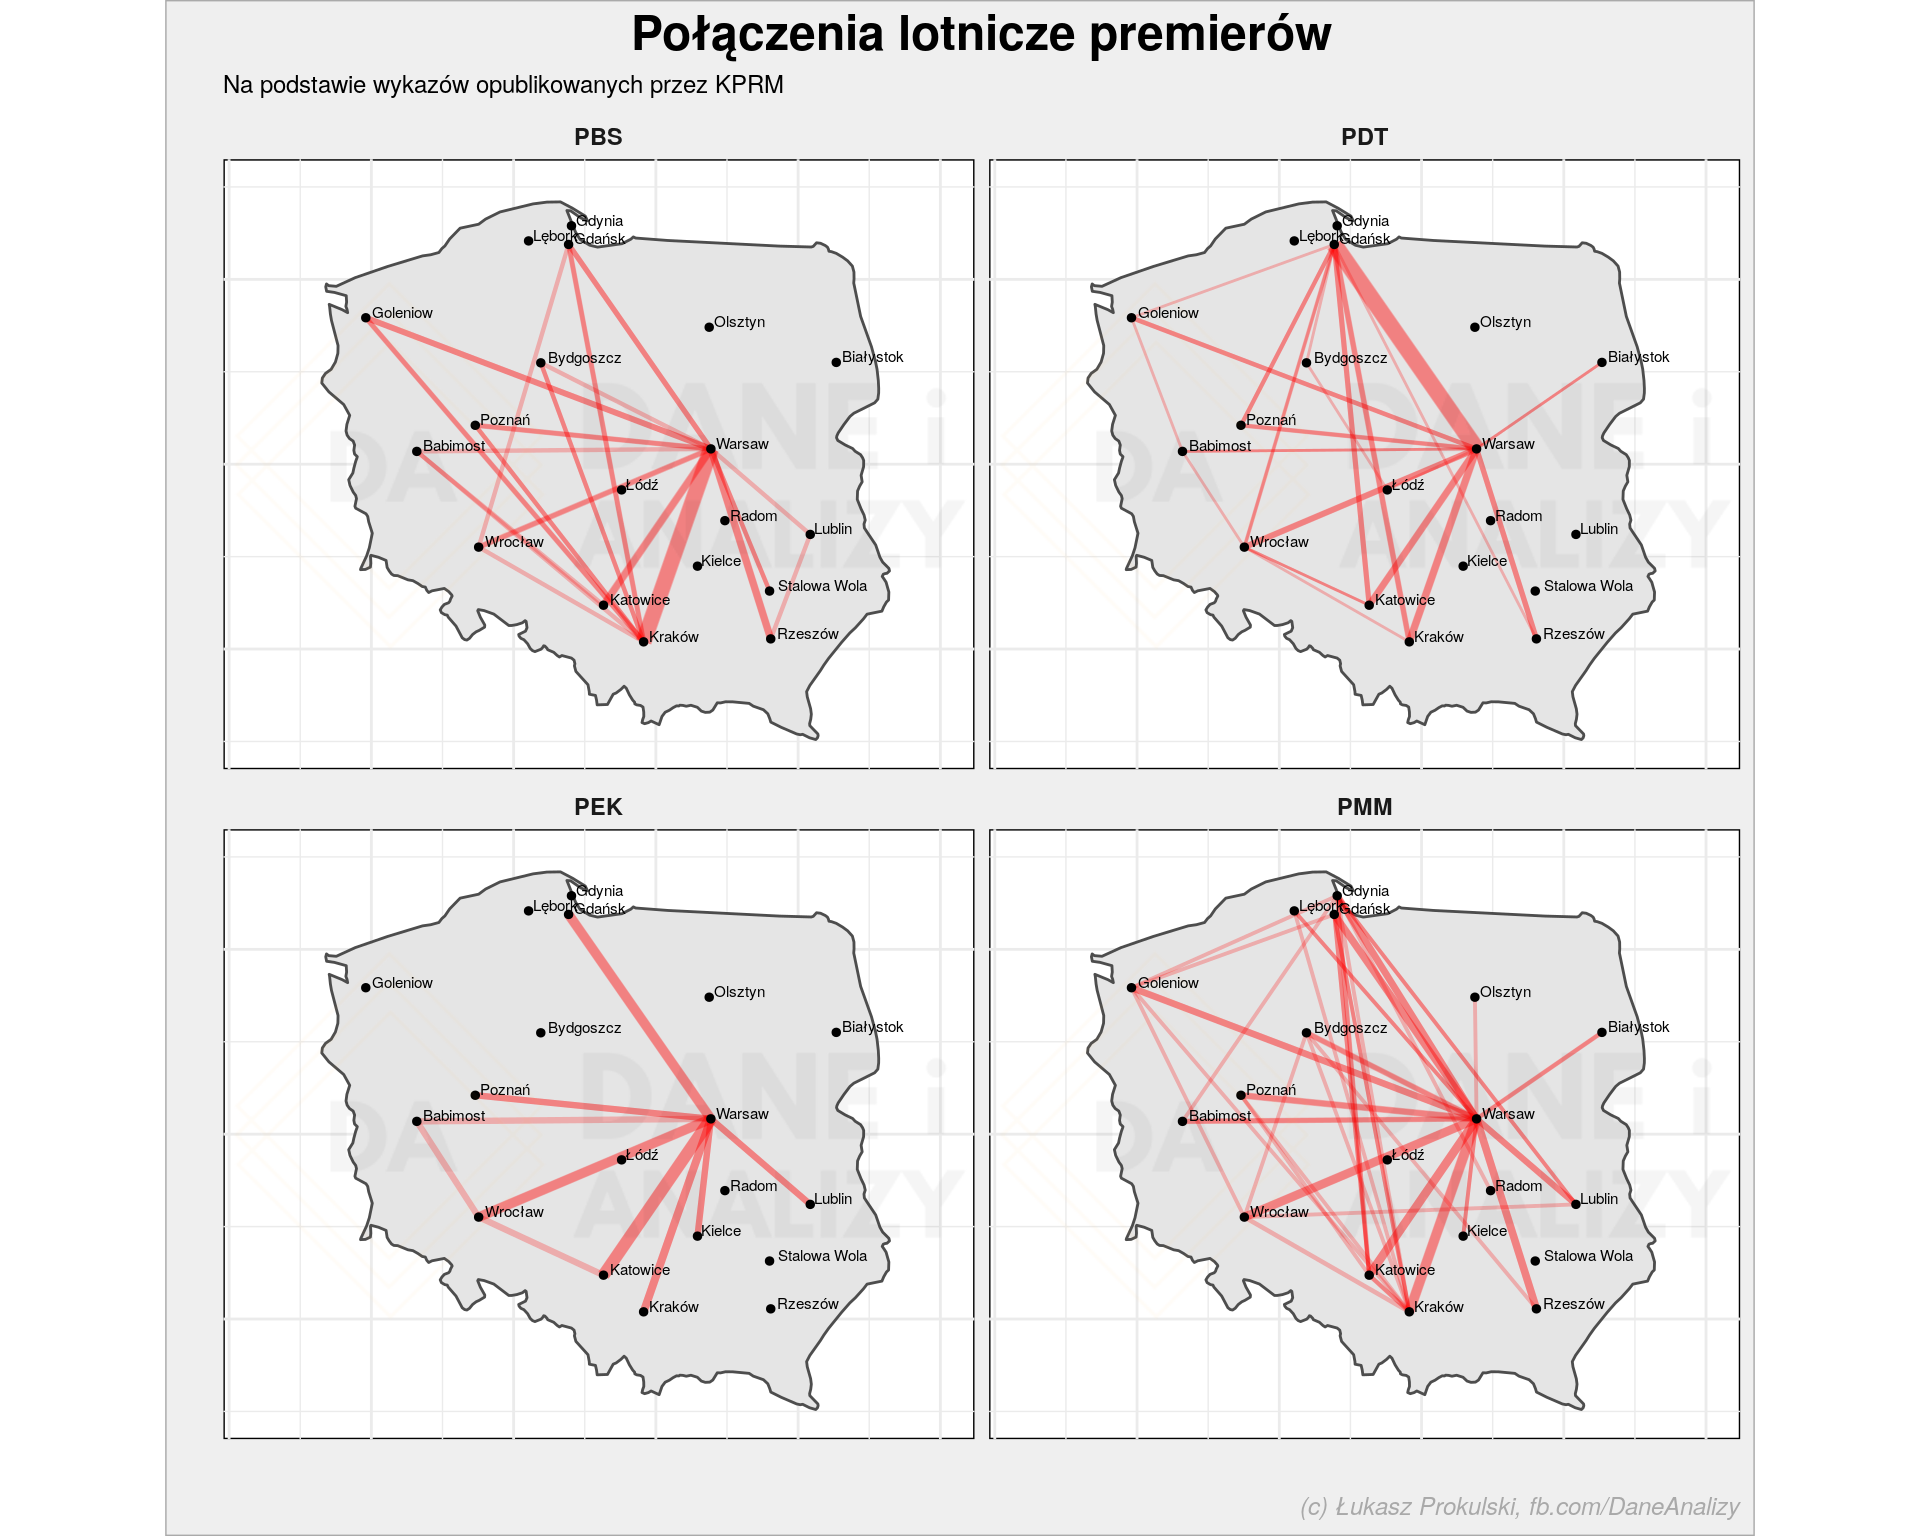
Albo - co ciekawsze - narysujmy mapkę z najczęściej pokonywanymi połączeniami przez każdego z premierów w Polsce:
# lista polskich lotnisk
lotniska_pl <- lotniska %>% filter(iso_country == "PL") %>% pull(ident)

loty %>%
  # tylko polskie lotniska
  filter(lotnisko_z %in% lotniska_pl & lotnisko_do %in% lotniska_pl) %>%
  # ile razy premier pokonywał daną trasę?
  count(kto, lat_z, long_z, miasto_z, lat_do, long_do, miasto_do) %>%
  # jaka to część jej/jego lotów
  group_by(kto) %>%
  mutate(n = n/sum(n)) %>%
  ungroup() %>%
  # rysujemy:
  ggplot() +
  # kontury Polski
  geom_polygon(data = map_data("world") %>%
                 filter(region == "Poland"),
               aes(long, lat, group=group),
               color = "gray30", fill = "gray90") +
  # połączenia lotnicze
  geom_segment(aes(x = long_z, xend = long_do,
                   y = lat_z, yend = lat_do,
                   size = n),
               alpha = 0.25, color = "red",
               show.legend = FALSE) +
  # punkty pokazujące położenie lotnisk
  geom_point(data = lotniska %>% filter(iso_country == "PL") %>%
               filter(ident %in% loty$lotnisko_z | ident %in% loty$lotnisko_do),
             aes(longitude_deg, latitude_deg),
             size = 1) +
  # nazwy miast, w których są lotniska
  geom_text(data = lotniska %>% filter(iso_country == "PL") %>%
              filter(ident %in% loty$lotnisko_z | ident %in% loty$lotnisko_do),
            aes(longitude_deg, latitude_deg, label = municipality),
            size = 2, hjust = -0.1, vjust = 0) +
  # ograniczamy zakres wykresu
  xlim(13, 25) +
  ylim(49, 55) +
  coord_map() +
  scale_size_continuous(range=c(0.5, 3)) +
  # każdy premier na swojej mapce
  facet_wrap(~kto) +
  # kosmetyka
  theme_minimal() +
  theme(axis.text = element_blank(), panel.grid = element_blank()) +
  labs(x = "", y = "")
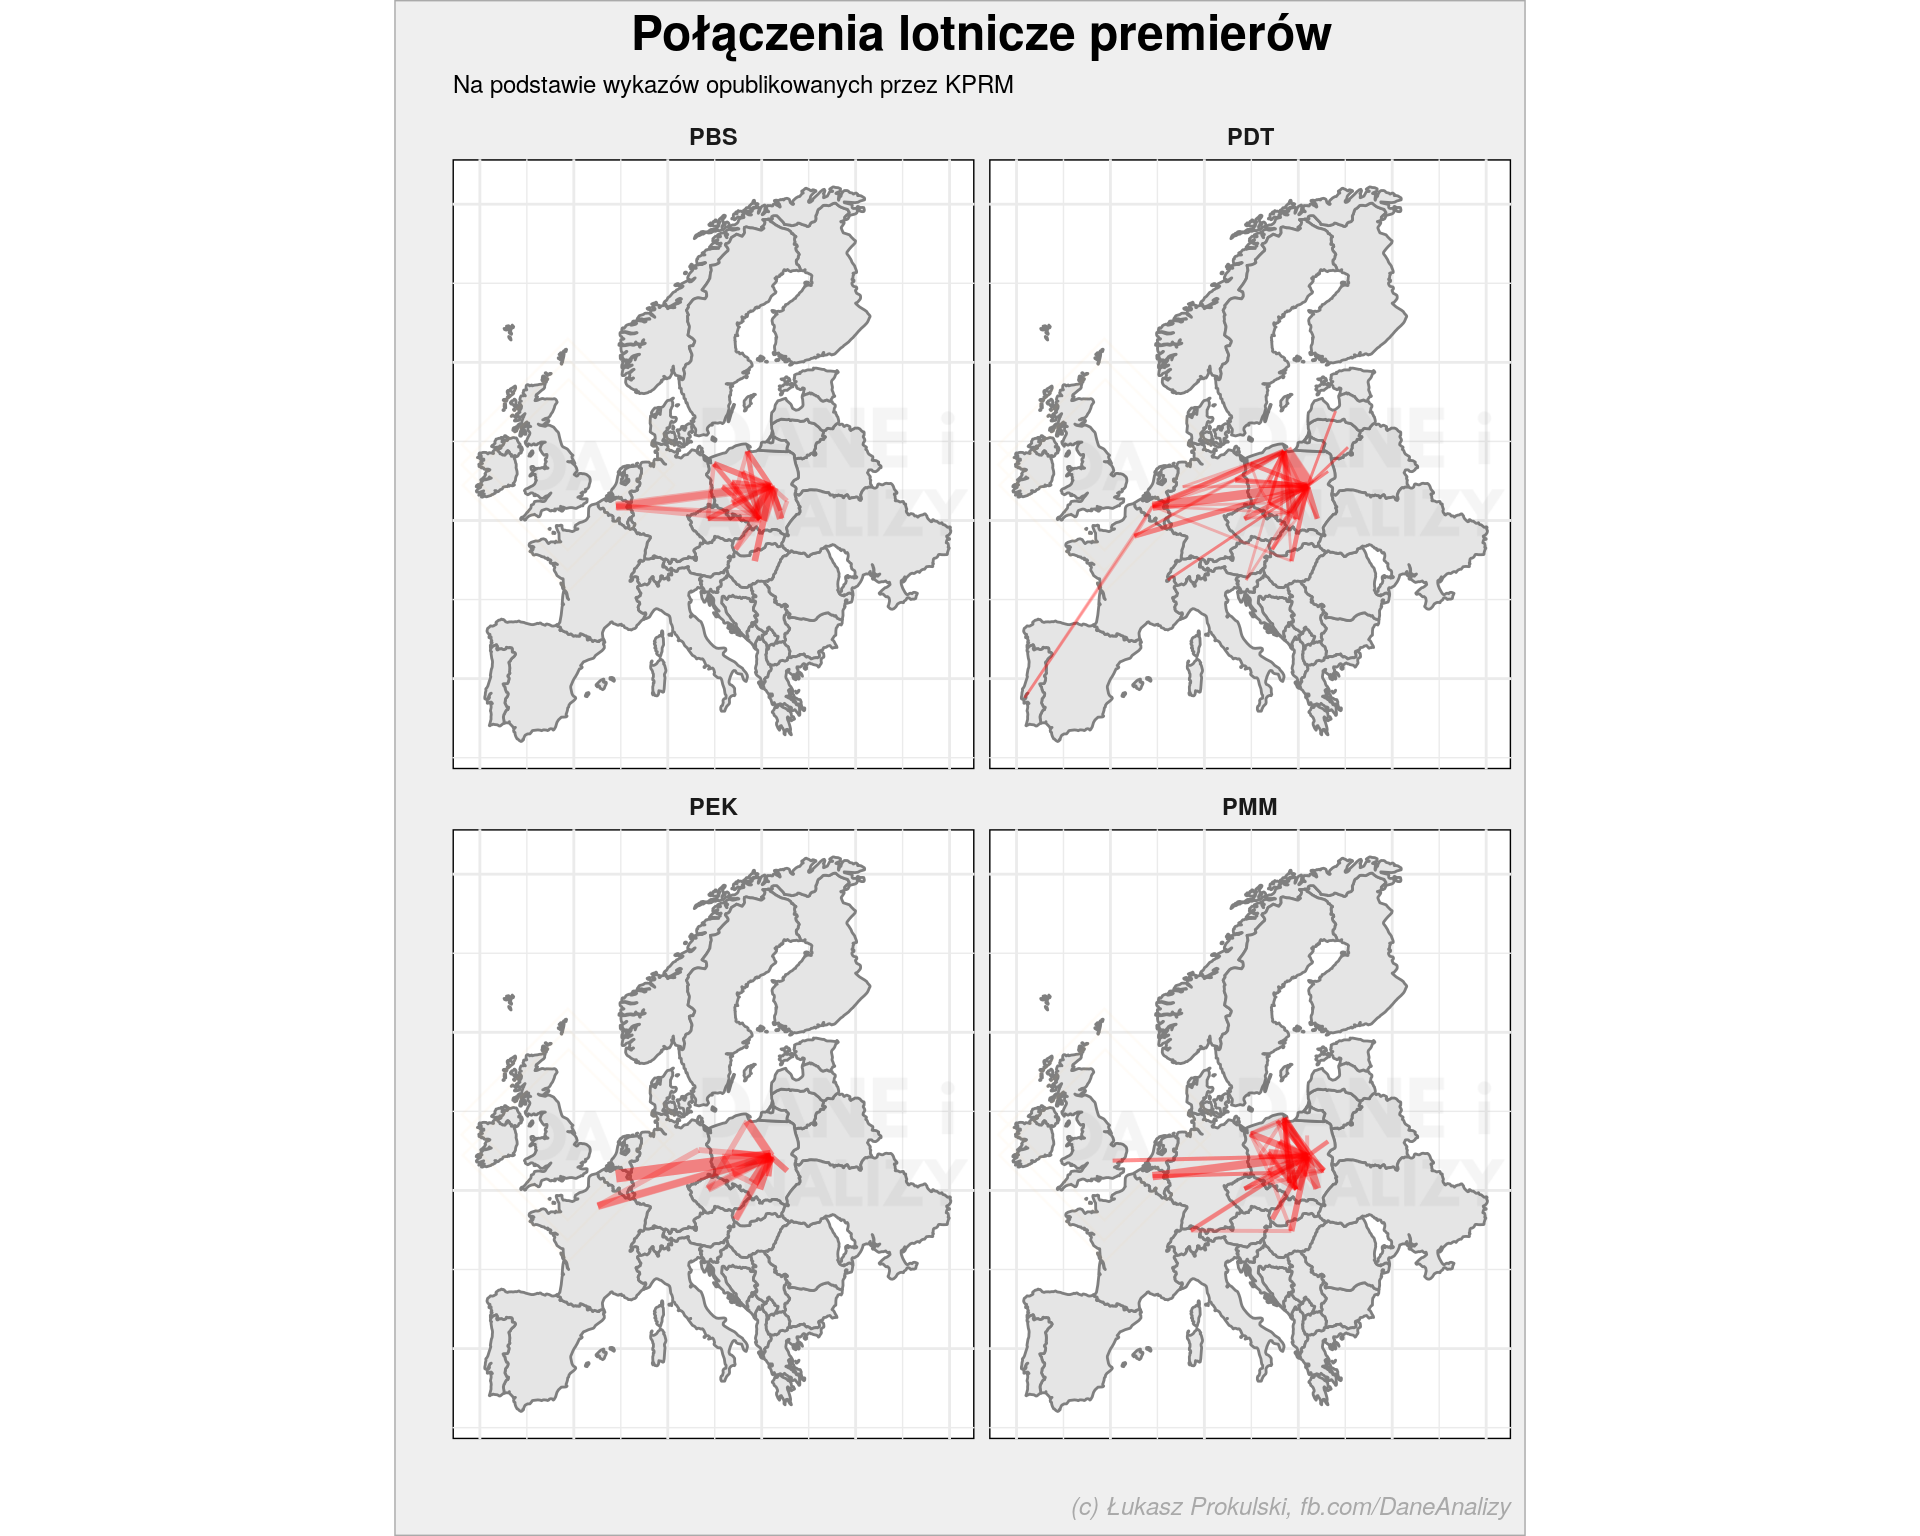
Możemy też sprawdzić jak latali po Europie:
# gdzie latają po Europie?
loty %>%
  count(kto, lat_z, long_z, miasto_z, lat_do, long_do, miasto_do) %>%
  mutate(kto = toupper(kto)) %>%
  group_by(kto) %>%
  mutate(n = n/sum(n)) %>%
  ungroup() %>%
  ggplot() +
  borders("world", xlim = c(-10, 25), ylim = c(39, 70), fill = "gray90") +
  geom_segment(aes(x = long_z, xend = long_do,
                   y = lat_z, yend = lat_do,
                   size = n),
               alpha = 0.25, color = "red",
               show.legend = FALSE) +
  coord_map() +
  scale_size_continuous(range=c(0.5, 3)) +
  facet_wrap(~kto) +
  theme_minimal() +
  theme(axis.text = element_blank(),
        panel.grid = element_blank()) +
  labs(x = "", y = "")
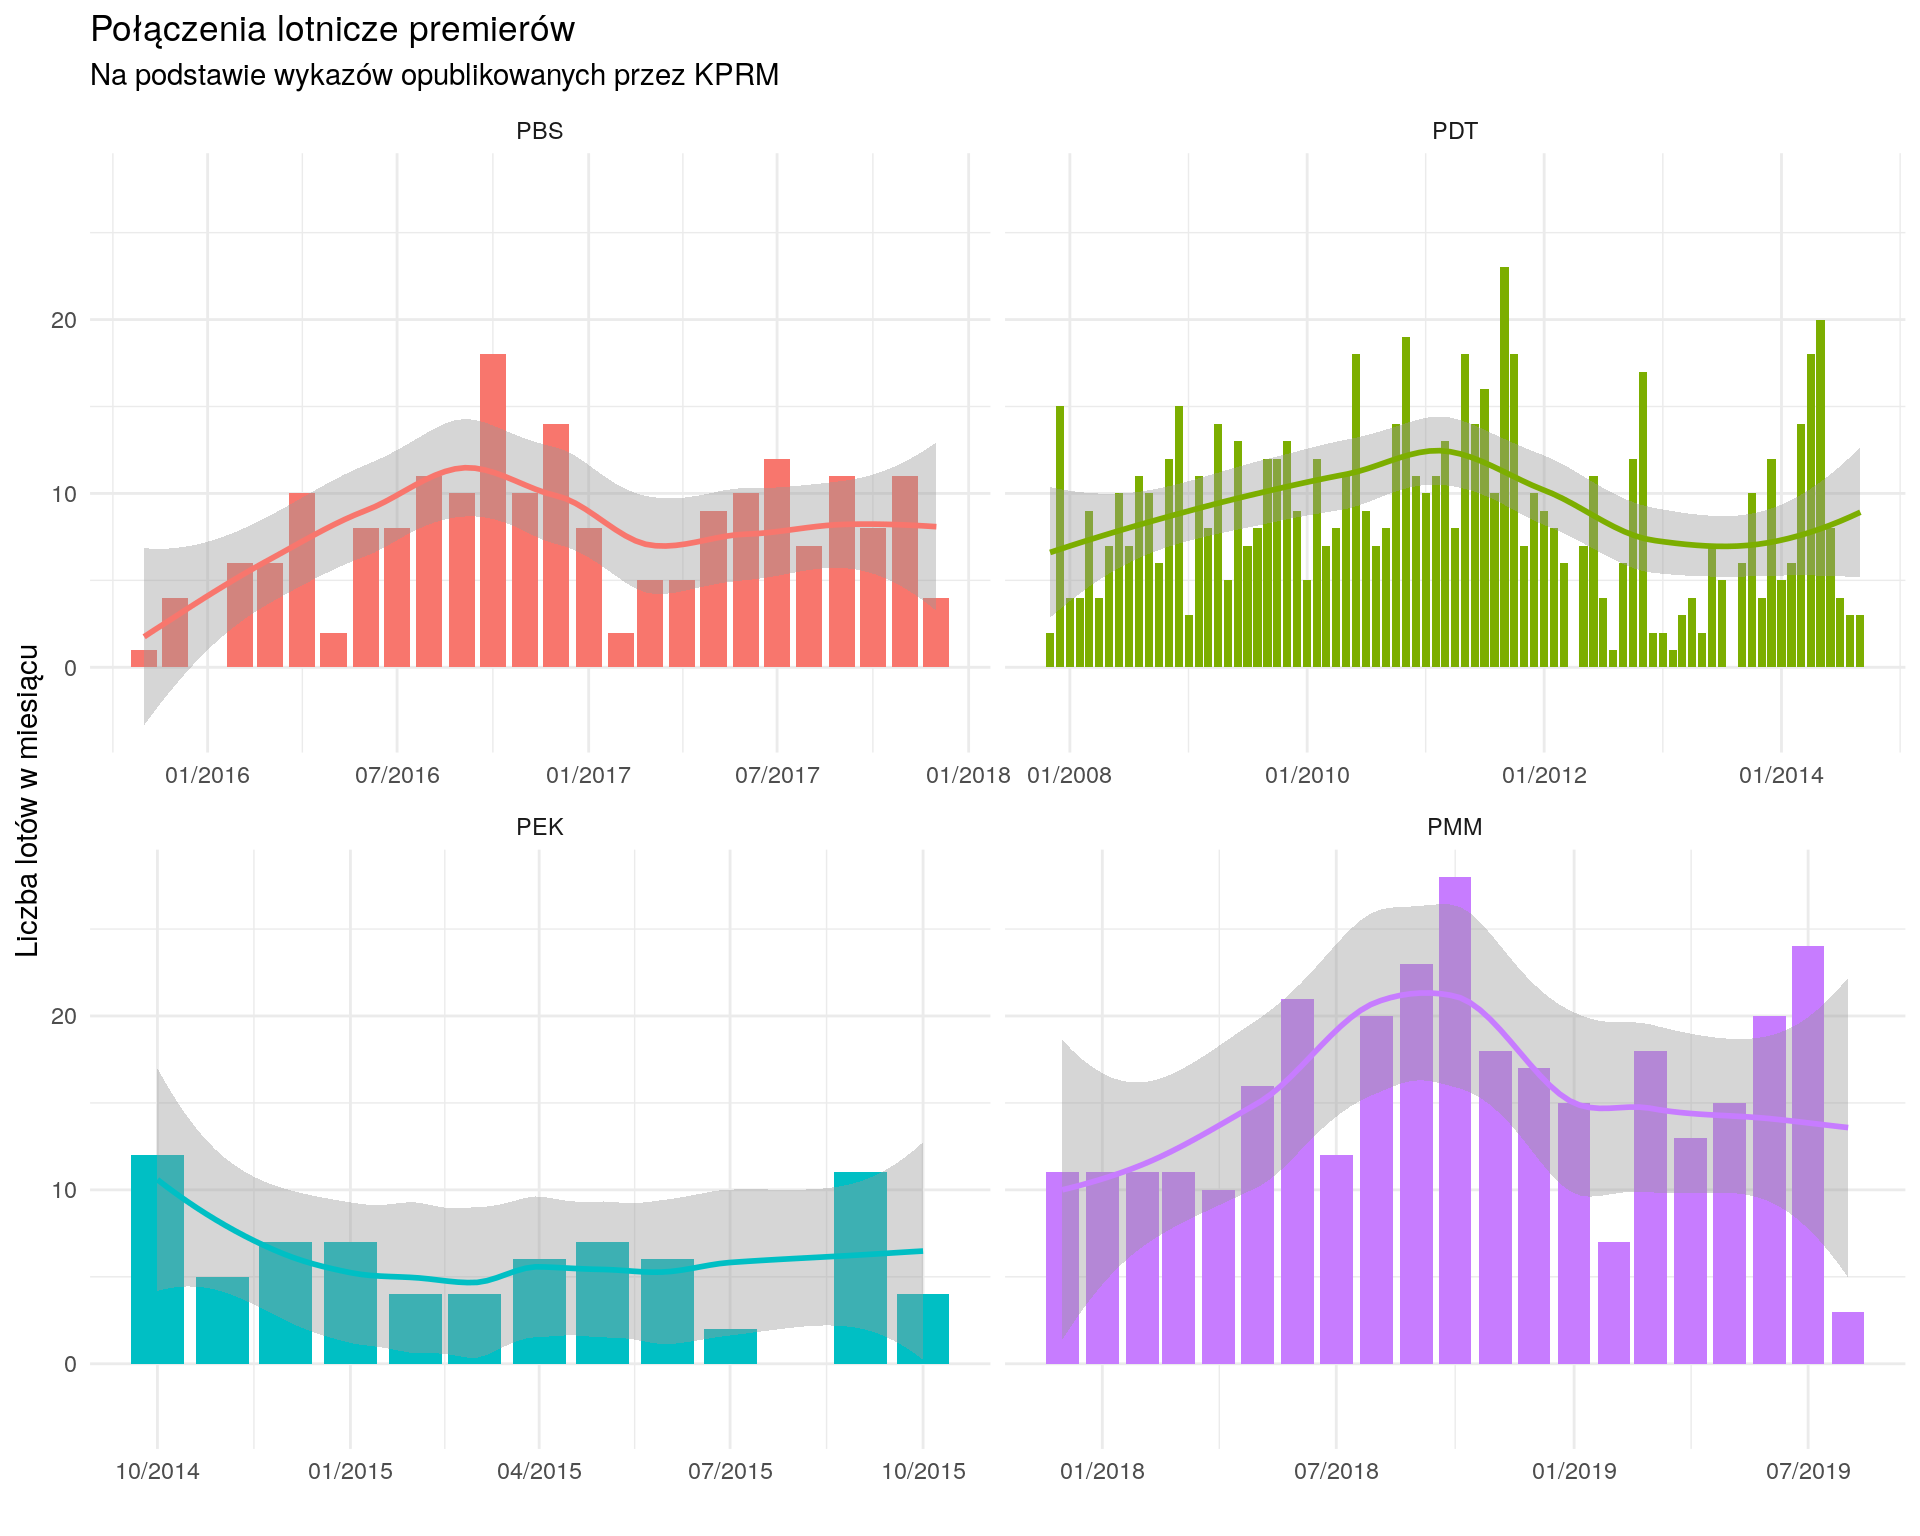
oraz liczbę lotów w kolejnych miesiącach:
loty %>%
  mutate(data2 = floor_date(data2, "month")) %>%
  count(kto, data2) %>%
  ggplot() +
  geom_col(aes(data2, n, fill = kto), show.legend = FALSE) +
  geom_smooth(aes(data2, n, color = kto), show.legend = FALSE) +
  facet_wrap(~kto, scales = "free_x") +
  scale_x_date(date_labels = "%m/%Y") +
  theme_minimal() +
  labs(x = "", y = "Liczba lotów w miesiącu")
Kto lata najczęściej?
loty %>%
  group_by(kto) %>%
  summarise(mind = min(data2, na.rm = T),
            maxd = max(data2, na.rm = T),
            n = n()) %>%
  ungroup() %>%
  mutate(diff_date = as.numeric(maxd - mind)) %>%
  mutate(day_per_flight = round(diff_date/n, 2)) %>%
  select(-mind, -maxd) %>%
  set_names(c("Premier", "Liczba lotów", "Liczba dni urzędowania", "Częstotliwość lotów")) %>%
  kable() %>%
  kable_styling(bootstrap_options = c("striped", "hover", "condensed", "responsive"))
| Premier | Liczba lotów | Liczba dni urzędowania | Częstość lotów (co ile dni lot) |
|---|---|---|---|
| PBS | 200 | 741 | 3.70 |
| PDT | 740 | 2471 | 3.34 |
| PEK | 75 | 382 | 5.09 |
| PMM | 324 | 598 | 1.85 |
Wnioski wyciągajcie sami (są mocno zależne od upodobań politycznych). Widać kilka rzeczy:
- Beata Szydło często latała na trasie Warszawa-Kraków oraz Warszawa-Katowice (lub odwrotnie) - to 54% jej lotów
- Donald Tusk często latał na trasie Warszawa-Gdańsk i z powrotem - to 50% jego lotów
- Ewa Kopacz latała głównie do Brukseli, latała też najrzadziej - średnio o 5 dni
- Mateusz Morawiecki lata dużo, więcej niż inni - ot średnio co niecałe dwa dni
Aktualizacja: nieco inaczej wyczyściłem dane i udało się wyłuskać jakimi samolotami latali poszczególni premierzy. Zestawienie w tabelce:
| Premier | Samolot | Liczba przelotów | % przelotów premiera |
|---|---|---|---|
| PDT | EMB | 276 | 48.68 |
| PDT | YK | 171 | 30.16 |
| PDT | TU | 58 | 10.23 |
| PDT | W3 | 39 | 6.88 |
| PDT | Bell | 13 | 2.29 |
| PDT | MI8 | 2 | 0.35 |
| PDT | YK/Bell | 2 | 0.35 |
| PDT | CASA | 1 | 0.18 |
| PDT | czarter | 1 | 0.18 |
| PDT | policja | 1 | 0.18 |
| PDT | W-3 | 1 | 0.18 |
| PDT | YK / EMB | 1 | 0.18 |
| PDT | YK/W3 | 1 | 0.18 |
| PEK | EMB | 41 | 87.23 |
| PEK | W3 | 5 | 10.64 |
| PEK | CASA | 1 | 2.13 |
| PBS | EMB | 73 | 45.34 |
| PBS | CASA | 72 | 44.72 |
| PBS | W-3 Sokół | 14 | 8.70 |
| PBS | B-737 czarter | 1 | 0.62 |
| PBS | W-3Sokół/CASA | 1 | 0.62 |
| PMM | EMB-175 | 131 | 63.59 |
| PMM | Gulfstream G-550 | 33 | 16.02 |
| PMM | CASA | 30 | 14.56 |
| PMM | Śmigłowiec W-3 | 7 | 3.40 |
| PMM | W-3 Sokół | 3 | 1.46 |
| PMM | G-550 | 1 | 0.49 |
| PMM | W3 | 1 | 0.49 |
W tabelce powyżej jeden przelot to jedna linia z pliku źródłowego, zatem na przykład lot Warszawa - Kraków - Rzeszów - Warszawa liczony jest jako jeden, chociaż wcześniej rozbity był na trzy odcinki. Trochę to miesza i może wprowadzić konfuzję jeśli chodzi o sumowanie, ale chodzi o porównanie skali a nie aptekę
Całość opracowania danych zajęła mi może z pół dnia. Dlaczego media tego nie zrobiły?
Cenisz rzetelne dziennikarstwo? To wymagaj go od mediów, za które płacisz. Albo płać tym, których cenisz :-)