
Kulki w Monte Carlo
Symulacje to coś, do czego komputery nadają się najlepiej. Zamiast liczyć na kartce wykorzystujemy maszynę i dostajemy wynik. Dzisiaj policzymy liczbę Pi i przeanalizujemy pewien teleturniej telewizyjny.
Liczba Pi i metoda Monte Carlo
Policzymy wartość liczby Pi… upuszczając ołówek na kartkę. Możecie zrobić to samodzielnie, albo wykorzystując metodę Monte Carlo. Metoda Monte Carlo to numeryczny sposób rozwiązywania problemów. Wykonujemy bardzo dużo obliczeń (opartych o losowe symulacje) i na podstawie ich wyniku coś określamy. Metoda została opracowana przez Stanisława Ulama, który należał do tak zwanej lwowskiej szkoły matematycznej i był między innymi współtwórcą amerykańskiej bomby termojądrowej (co akurat powinno wzbudzić szacun a nie jakiś postrach). Ulam był też jednym z pierwszych naukowców, którzy wykorzystywali w swych pracach komputer. Możecie (zachęcam!) obejrzeć film o lwowskiej szkole matamatycznej pochodzący z kanału Historia Bez Cenzury - mam nadzieję, że wzbudzi Wasz podziw (i odkrycie ludzkich cech u matematyków) dla polskich przedwojennych matematyków. Każdy kto miał na studiach matematykę (wszystkie uczelnie techniczne) zapewne słyszał o przestrzeni Banacha. Tak, ma to związek z lwowską szkołą, a Banach zresztą pochowany jest na Cmentarzu Łyczakowskim, podobnie jak wielu innych znanych Polaków (ze znanych ze szkoły nazwisk: Maria Konopnicka i Gabriela Zapolska). Wróćmy jednak do naszego eksperymentu. Polega on na losowym upuszczeniu (na przykład) ołówka, tak aby zaznaczył punkt na kartce. Wcześniej na tej kartce rysujemy koło i opisany na nim kwadrat. Ołówkiem rzucamy z góry tak, aby trafić w kwadrat. Liczymy liczbę rzutów i liczbę trafień w koło. Zamiast robić to ręcznie wykorzystamy komputer (i oczywiście R). Zamiast rzucania wylosujemy punkt:
kolo <- data_frame(x = numeric(), y = numeric(), k = logical())

# promień koła
r <- 100

# rzucamy 5000 razy ołówkiem
for(i in 1:5000) {

   # losowe współrzędne punktu
   x <- (-1)^sample(c(1, 2), 1) * sample(0:r, 1)
   y <- (-1)^sample(c(1, 2), 1) * sample(0:r, 1)

   # w jakim miejscu upadł ołówek?
   kolo[i, "x"] <- x
   kolo[i, "y"] <- y

   # czy wylosowany punkt wypadł w kole?
   kolo[i, "k"] <- ifelse(x^2 + y^2 <= r^2, TRUE, FALSE)
}
Gdzie upadł ołówek?
library(tidyverse)

kolo %>%
   ggplot() +
   geom_point(aes(x, y, color = k)) +
   coord_equal() +
   labs(color = "Czy punkt\njest w kole?")
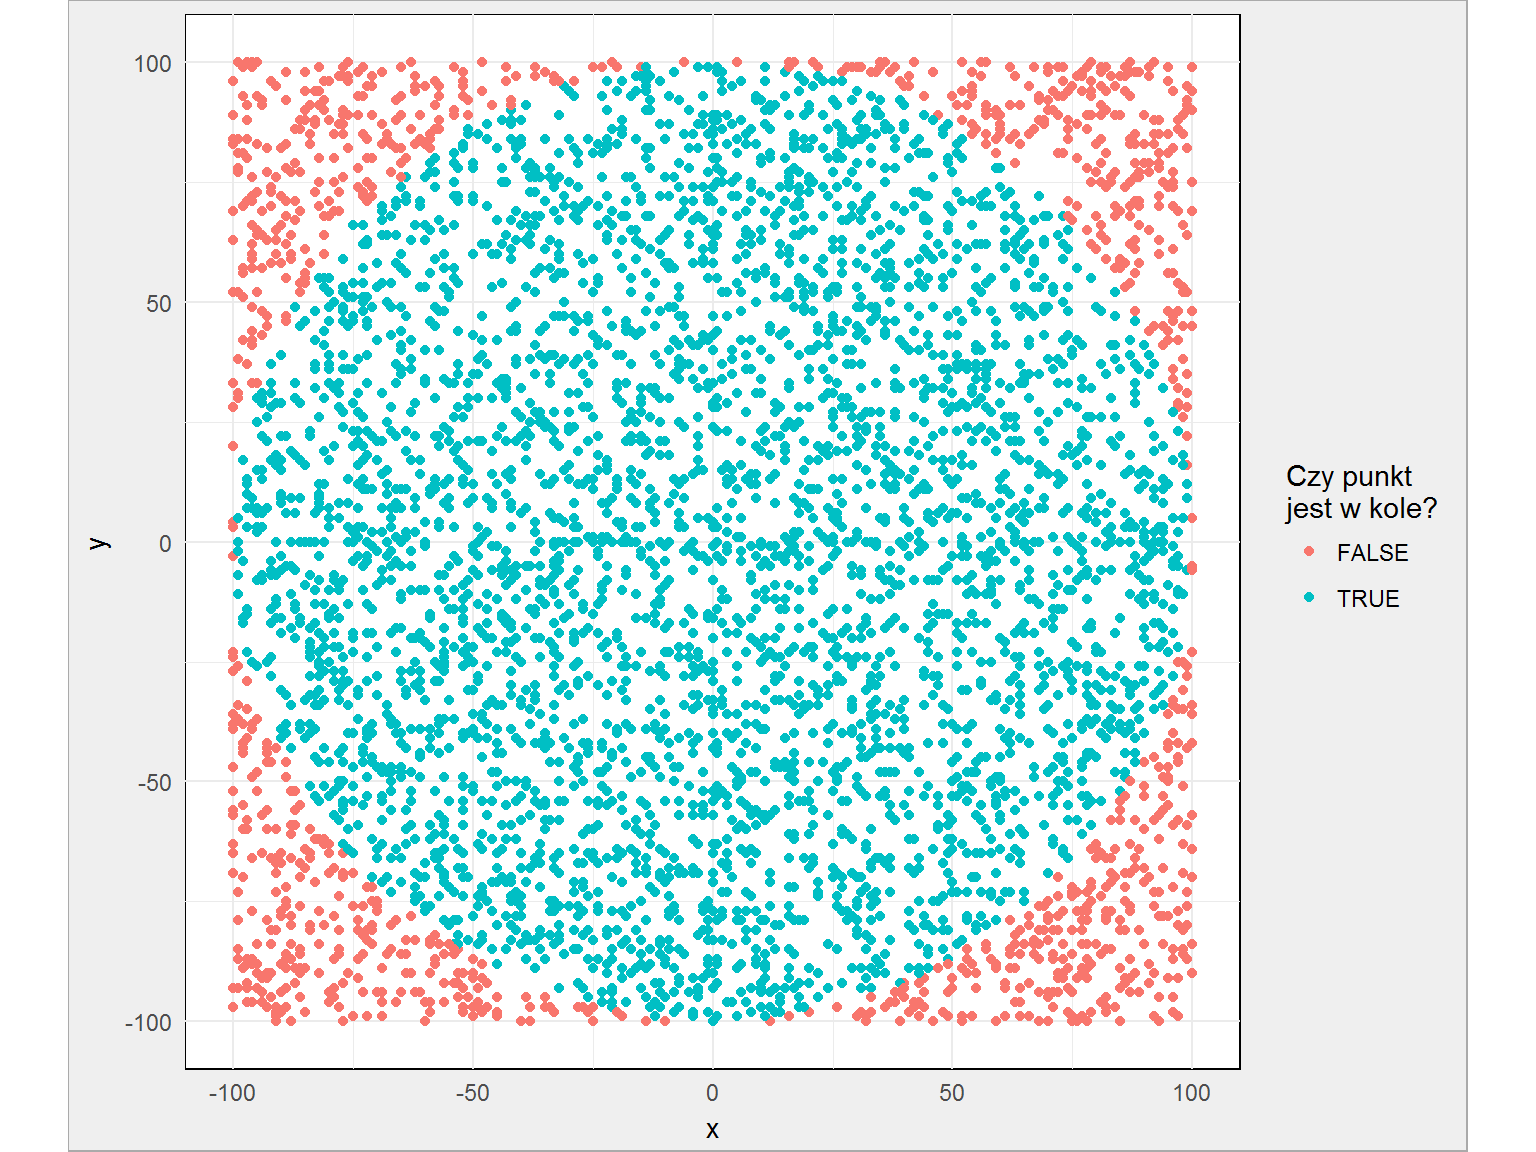 Widać, że mniej więcej wszystkie punkty rozłożone są równomiernie. Liczba Pi to liczba punktów w kole w stosunku do liczby wszystkich punktów - daje nam to 3.0896, czyli całkiem niezły wynik. Dla przypomnienia Pi to 3.1415926 (tyle liczb pamiętam).
A teraz to samo ćwiczenie powtórzymy miliony razy. (Prawie) za każdym razem z różną liczbą upuszczanych ołówków - tak, aby sprawdzić dokładność metody i czy z większą liczbą losowań (ołówków) dostaniemy lepszy wynik?
df <- data.frame(i = numeric(), p = numeric(), pi_mc = numeric())

r <- 1000
k <- 0
max_p <- 200
max_j <- 16

for(j in 1:max_j) {
   # określamy liczbę losowań - kolejne potęgi dwójki
   max_i <- 2^j

   # prosty "progress bar" :)
   cat(paste("\rj:", j, "/", max_j, "\tmax_i: ", max_i, "\n"))

   # dla każdego z max_p losowych kółek
   for(p in 1:max_p) {

      # losujemy max_i punktów i sprawdzamy czy wypadają w kole
      kolo <- 0
      for(i in 1:max_i) {

         # losowe współrzędne koła
         x <- (-1)^sample(1:max_i, 1) * sample(0:r, 1)
         y <- (-1)^sample(1:max_i, 1) * sample(0:r, 1)

         # czy wylosowany punkt wypadł w kole?
         if(x^2 + y^2 <= r^2) kolo <- kolo + 1
      }

      # obliczamy Pi
      Pi <- 4 * kolo / max_i # 4, bo kwadrat ma pole 4r^2: (2r)^2, gdzie r jest od -r do +r

      # zapisujemy wyniki w tabeli
      k <- k + 1
      df[k, "i"] <- max_i
      df[k, "pi_mc"] <- Pi
      df[k, "p"] <- p
   }
}
Obliczenia trwają długo - mamy po 2, 4, 8, …, 216 losowanych punktów dla jednego koła, a kół będzie po 200 dla każdej z liczby losowanych punktów. Łącznie daje to sum(200*2^(1:16)) losowanych punktów w kole (czyli jakieś 26.2 milionów losowań).
obliczenia są bardzo długie i poprawnie byłoby je zrównoleglić (przeczytaj tekst), a jeszcze lepiej napisać w C/C++ (z pomocą pakietu Rcpp - polecam tekst oraz wpis). Tutaj tego nie użyłem ze względu na czytelność kodu, a także charakter wpisu - chodzi mi o wyjaśnienie algorytmu i komplikowanie całości przez wprowadzenie dodatkowych rozwiązań do niczego dobrego nie prowadzi.
Zobaczmy co nam wyszło - jak wygląda wartość Pi w zależności od liczby losowań?
df %>%
   ggplot() +
   geom_boxplot(aes(i, pi_mc, group=i), fill = "lightgreen", color = "darkred") +
   geom_hline(yintercept = pi, color="red") +
   geom_jitter(aes(i, pi_mc), width = 0.05, alpha=0.1, color = "blue") +
   scale_x_log10()
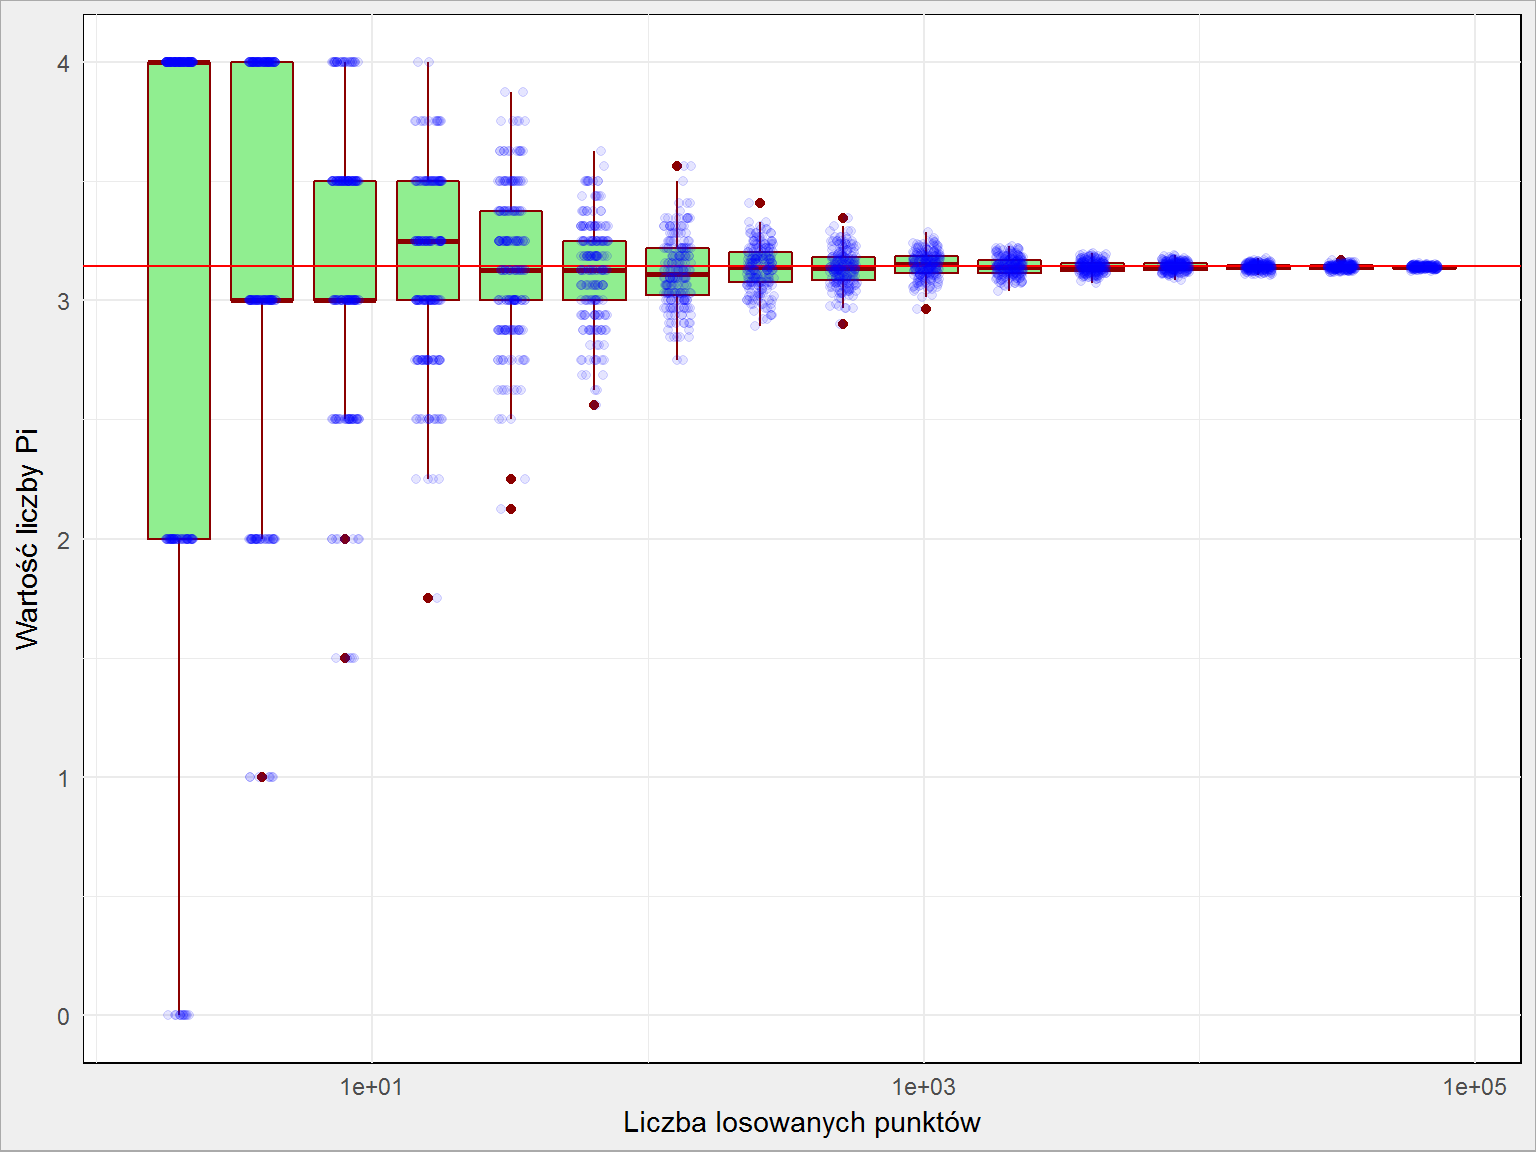 Widzimy, że im więcej powtórzeń tym bardziej obliczona liczba Pi bliższa jest wartości prawdziwej, jednocześnie z coraz mniejszym rozrzutem. W którymś momencie dokładność jest wystarczająca.
Do czego można to wykorzystać? Całkowanie! W metodzie MC możemy zrealizować to poprzez losowanie dla każdego X jakiejś wartości (wielokrotnie) i sprawdzanie czy jest pod czy nad krzywą, której całkę chcemy policzyć. To co jest pomiędzy osią OX (y = 0) a krzywą jest wartością naszej całki. Im więcej losowań dla danego X i im mniejsze odstępy pomiędzy kolejnymi Xami tym lepszy (dokładniejszy) wynik. Mechanika jest identyczna jak w przypadku kół i liczby Pi.
Będąc jeszcze przy liczbie Pi: wiecie, że rozkład wystąpienia poszczególnych cyfr jest mniej więcej równy? To znaczy, że biorąc pod uwagę na przykład tysiąc miejsc po przecinku otrzymamy zbiór liczb z 100 jedynek, 100 dwójek, 100 trójek i tak dalej? Dokładniej możecie to zobaczyć na poniższej animacji (via Reddit)
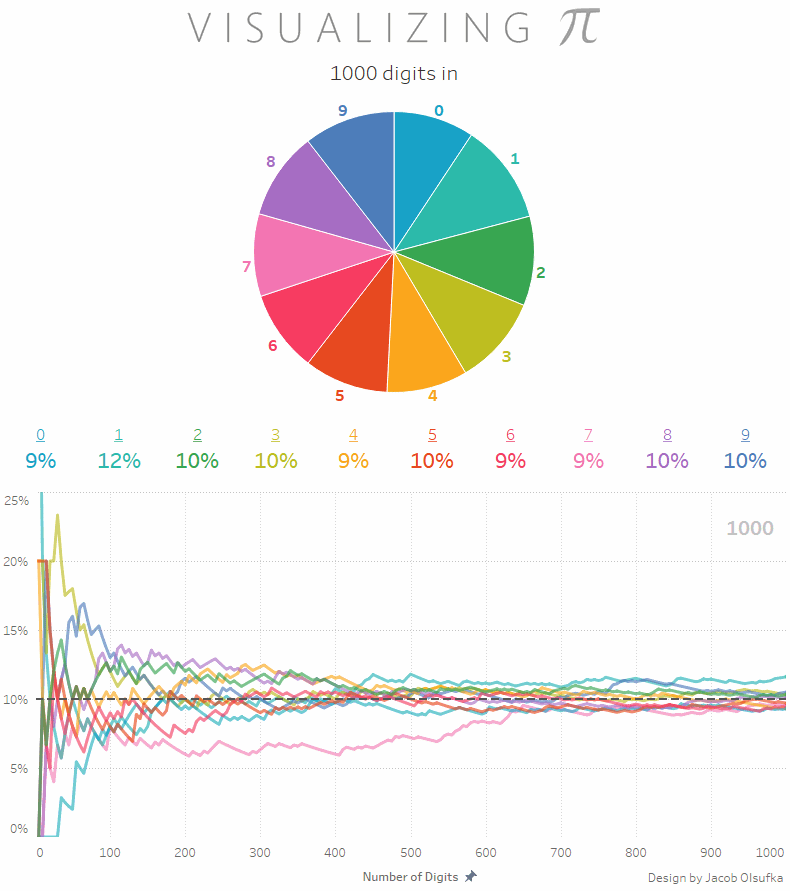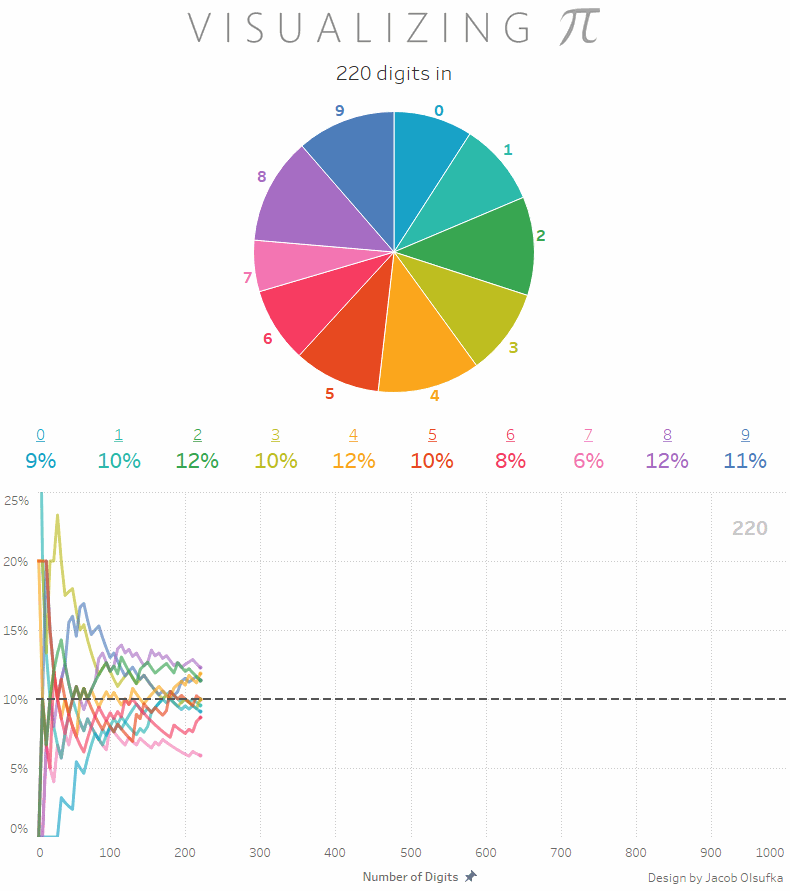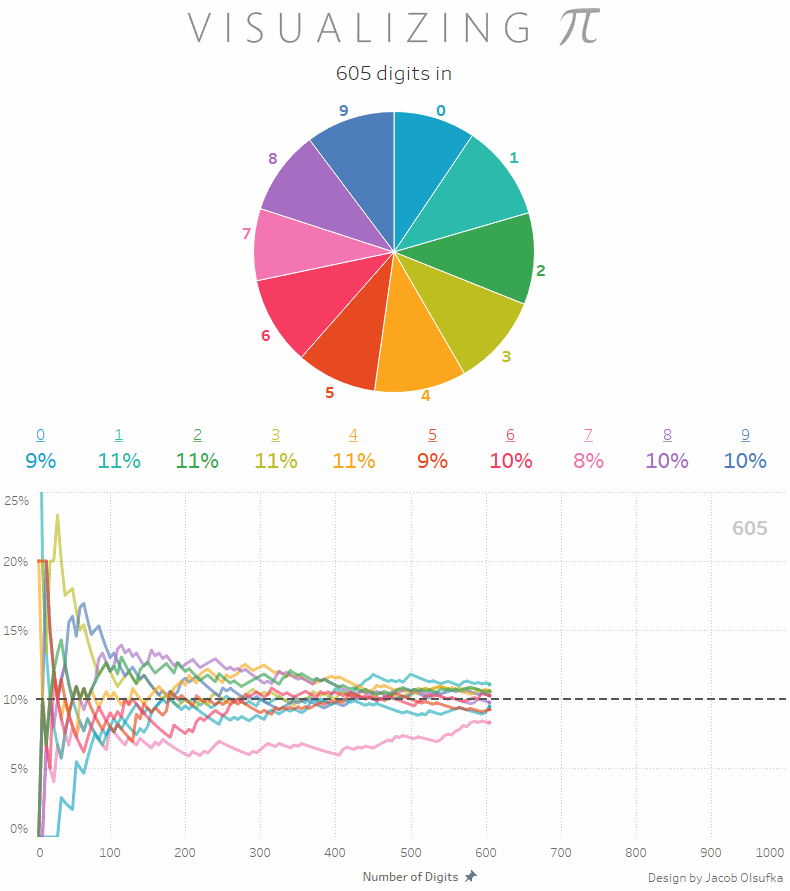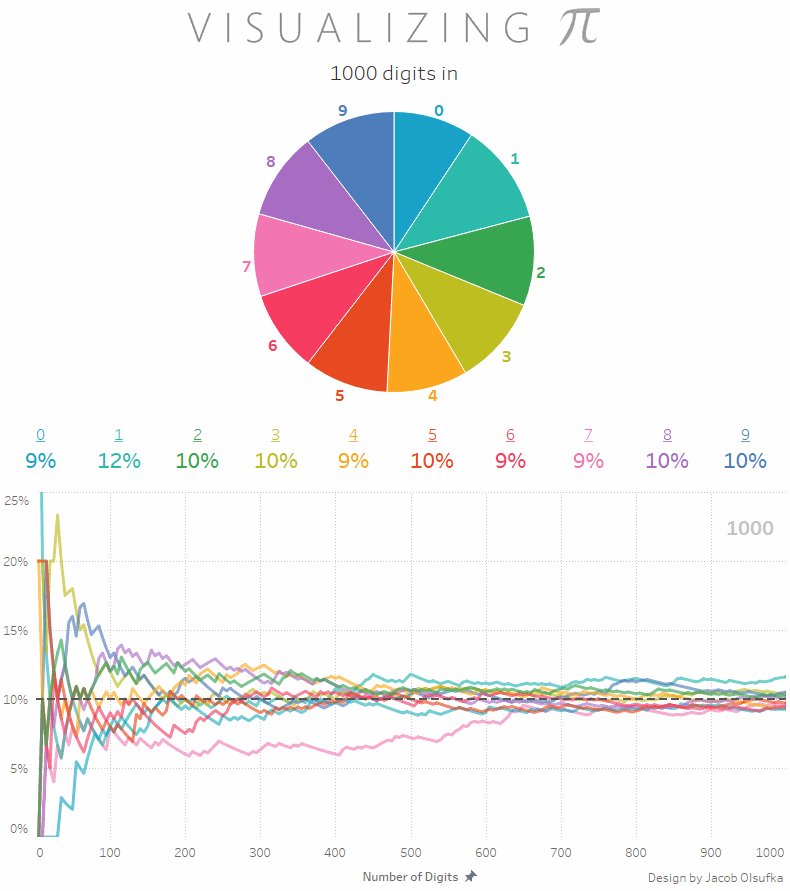 a jeśli samodzielnie chcecie sobie to sprawdzić to na stronie PiDay.org znajdziecie liczbę Pi w rozwinięciu do miliona miejsc po przecinku. Proszę policzyć rozkład poszczególnych cyfr. W pamięci. No dobra, może być na palcach ;)
Więcej o liczbie Pi chociażby na Wikipedii. Ciekawostką jest angielskie zdanie How I want a drink, alcoholic of course, after the heavy lectures involving quantum mechanics!. Dlaczego jest ciekawe? Ten kod da odpowiedź:
"How I want a drink, alcoholic of course, after the heavy lectures involving quantum mechanics!" %>%
   gsub("[,!]", "", .) %>%
   strsplit(" ") %>%
   unlist() %>%
   nchar()
Teleturniej “The Wall”
W piątkowy wieczór trafiłem w TVP na teleturniej “The Wall” (na postawie amerykańskiej wersji). Pokrótce polega on na odpowiadaniu na pytania, a nagrodą jest kwota określona na podstawie tego, gdzie wyląduje puszczona po ścianie kula. Plansza (owa ściana) jest mniej więcej prostokątna (to chyba raczej trapez, nie przyglądałem się aż tak dokładnie), uczestnik wybiera kolumnę z której wypada kula. Na każdym poziomie kula odbija się od wystających ze ściany kołków, co powoduje jej odbicie w lewo lub w prawo, czasem kula spada bez zmiany kierunku. Czy możemy określić z którego miejsca należy puszczać kulę, aby mieć największe szanse na najwyższe nagrody? Przygotujmy mechanizm symulujący drogę przez planszę dla pojedynczej kulki. Zaczniemy od wybranej kolumny, a przy przejściu do kolejnego rzędu wylosujemy kierunek zmiany (w lewo, w prawo albo bezpośrednio w dół). W zależności od wylosowanego kierunku zmieniamy numer kolumny w której będzie kulka (o jeden więcej, mniej albo bez zmiany) w kolejnym rzędzie. Założenie dodatkowe: przy dojściu do bocznej ściany kulka odbija się od niej.
rm(list = ls())

# rozmiar planszy
wysokosc_planszy <- 20
szerokosc_planszy <- 10

# startowa kolumna
kolumna <- 5

# definiujemy pustą planszę
plansza <- matrix(0, nrow = wysokosc_planszy, ncol = szerokosc_planszy)

# przejście przez planszę od góry w dół
for(rzad in 1:nrow(plansza)) {
   # w odpowiednim rzędzie i kolumnie zapisujemy położenie kulki
   # w tym przypadku jest to numer kolejnego kroku równy rzędowi
   plansza[rzad, kolumna] <- rzad

   # w lewo, w prawo czy w dół? losujemy kierunek
   switch(sample(c("L", "P", "S"), size = 1),
          "L" = kolumna <- kolumna + 1,
          "P" = kolumna <- kolumna - 1,
          "S" = kolumna <- kolumna)

   # odbicie od prawej krawędzi planszy
   if(kolumna > szerokosc_planszy) kolumna <- ncol(plansza)

   # odbicie od lewej krawędzi planszy
   if(kolumna == 0) kolumna <- 1
}
Co z tego wyszło? Zobaczmy na obrazku (wpierw robiąc trochę gimnastyki z macierzą tak, aby łatwo ją narysować z użyciem ggplot):
plansza %>%
   as.data.frame() %>%
   mutate(Rzad = row_number()) %>%
   gather(key = Kolumna, value = Krok, -Rzad) %>%
   mutate(Kolumna = as.numeric(gsub("V", "", Kolumna))) %>%
   mutate(Kolumna = factor(Kolumna, levels = 1:szerokosc_planszy),
          Rzad = factor(Rzad, levels = wysokosc_planszy:1)) %>%
   ggplot() +
   geom_tile(aes(Kolumna, Rzad, fill = ifelse(Krok == 0, "white", "black")),
             color = "black", show.legend = FALSE) +
   geom_text(aes(Kolumna, Rzad, label = ifelse(Krok == 0, "", Krok))) +
   scale_fill_manual(values = c("white" = "white", "black" = "orange"))
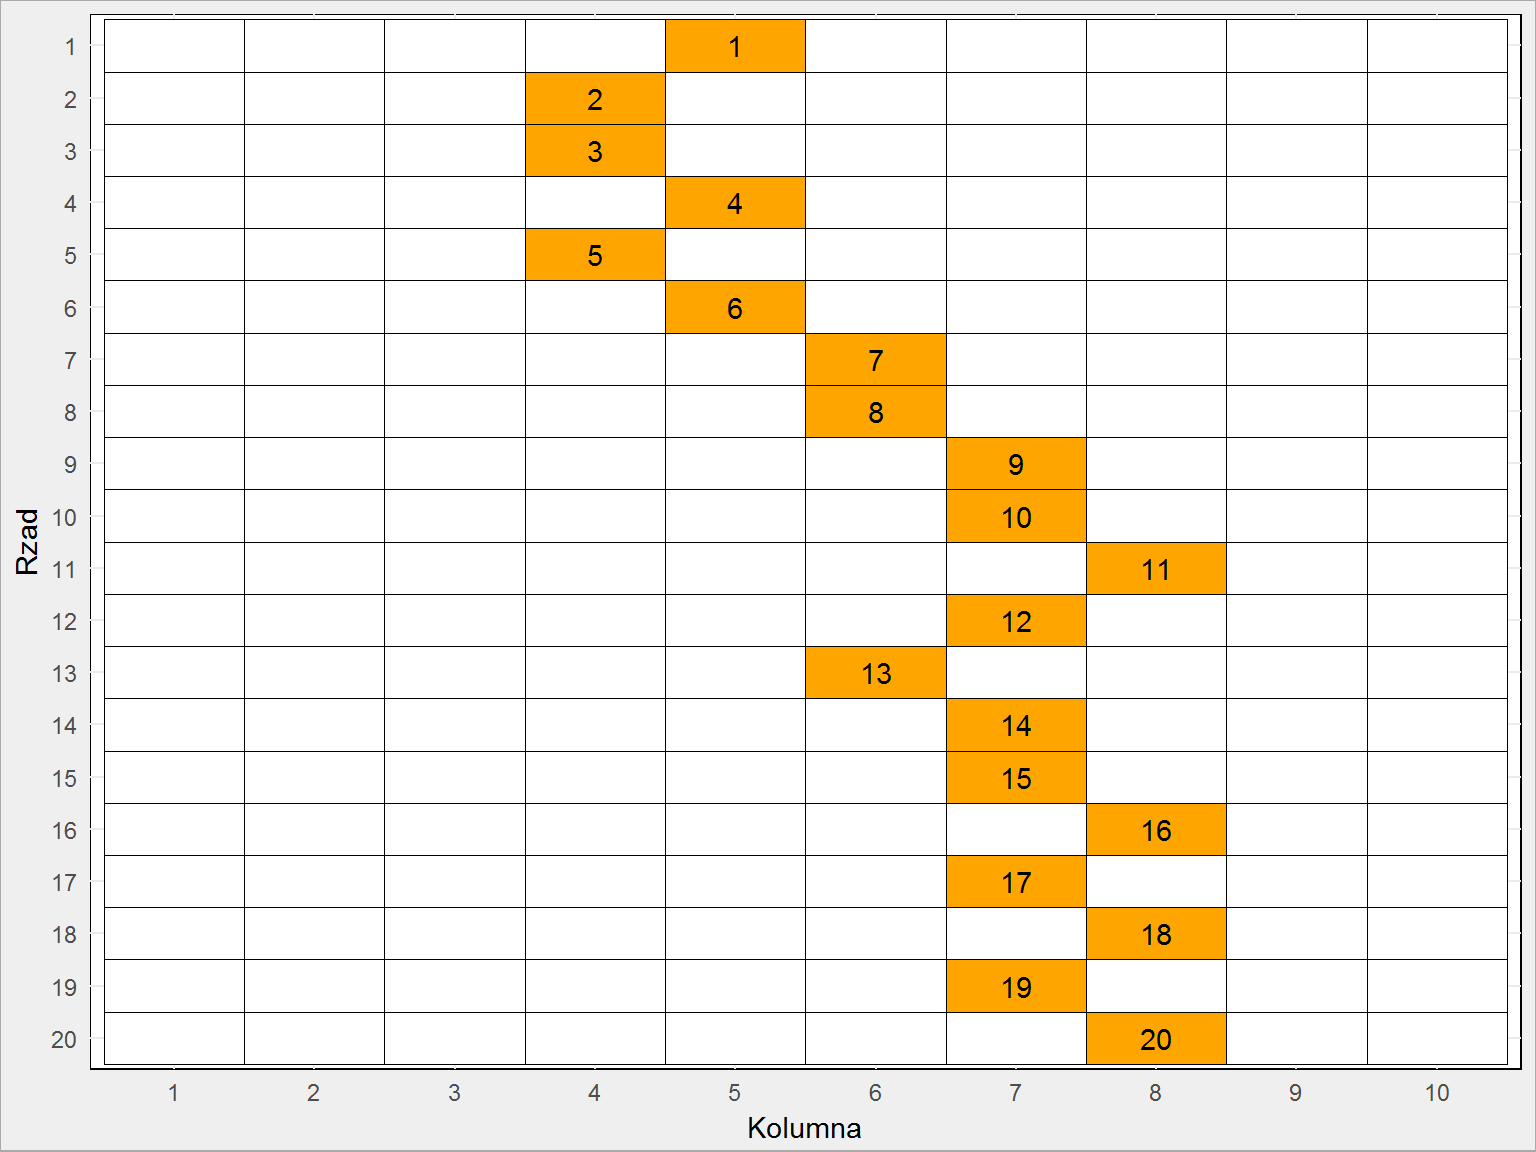 Na pomarańczowo widzimy drogę jaką przebyła kula, a liczby w pomarańczowych polach to kolejny krok.
Wiecie, że to wszystko to łancuch Markova (w najprostszym wariancie zwanym spacerem losowym)? To znaczy, że stan przyszły (w naszym przypadku numer kolumny w kolejnym rzędzie) zależy tylko od stanu obecnego (numer kolumny w aktualnym rzędzie). Kulka nie pamięta swojej historii (i nie wie, że jeśli ostatnio było w prawo to teraz na przykład powinno być w lewo). Istnieje oczywiście pakiet do tego typu zagadnień -
mcmc, ale szczerze mówiąc nie zagłębiałem się w niego i nie wiem jak to samo zrobić za jego pomocą. Na pewno krócej i szybciej.
Teraz zrobimy dokładnie to samo co z rzucaniem ołówkiem - powtórzymy to samo ćwiczenie tysiące razy. Dodatkowo zaczynając od każdej z kolumn.
df <- data_frame()

iteracje <- 10000
powtorki <- 1000

# powtorka wszystkich przejść
for(t in 1:powtorki) {
   # amatorski progress bar :)
   cat(paste0("\rt = ", t, "/", powtorki))

   # losowy generator losowy :)
   set.seed(floor(runif(1, min = 1, max = 5000)))

   # dla każdej kolumny startowej...
   for(kolumna_startowa in 1:szerokosc_planszy) {

      # ... definiujemy czystą planszę sumaryczną...
      plansza_full <- matrix(0, nrow = wysokosc_planszy, ncol = szerokosc_planszy)

      # ...robimy 'iteracje' powtorzeń przejścia przez planszę
      for(i in 1:iteracje) {
         # czyścimy planszę
         plansza <- matrix(0, nrow = wysokosc_planszy, ncol = szerokosc_planszy)

         # zaczynamy od kolumny startowej
         kolumna <- kolumna_startowa

         # przejście przez planszę od góry w dół
         for(rzad in 1:nrow(plansza)) {

            # jedynką oznaczamy pozycję kulki
            plansza[rzad, kolumna] <- 1

            # w lewo, w prawo czy w dół?
            switch(sample(c("L", "P", "S"), size = 1),
                   "L" = kolumna <- kolumna + 1,
                   "P" = kolumna <- kolumna - 1,
                   "S" = kolumna <- kolumna)

            # odbicie od prawej strony
            if(kolumna > szerokosc_planszy) kolumna <- ncol(plansza)

            # odbicie od lewej strony
            if(kolumna == 0) kolumna <- 1
         }

         # heatmapa wszystkich przejść = suma wszystkich plansz
         plansza_full <- plansza_full + plansza
      }

      # największe prawdopodobieństwo zakończenia
      # w której kolumnie ostatniego wiersza było najwięcej kulek na planszy sumarycznej?
      df <- bind_rows(df, data_frame(start = kolumna_startowa, finisz = which.max(plansza_full[wysokosc_planszy,])))
   }
}
Znowu trwało to bardzo długo, znowu nalepiej byłoby to zrobić korzystając ze zrównoleglenia obliczeń i opierając je na kodzie w C/C++. Zysk na wydajności byłby pewnie z 20-30 krotny. Ale zobaczmy gdzie wpadała kula (oś pionowa) w zależności od tego skąd została wyrzucona (oś pozioma):
df %>%
   ggplot() +
   geom_jitter(aes(start, finisz), alpha = 0.1)
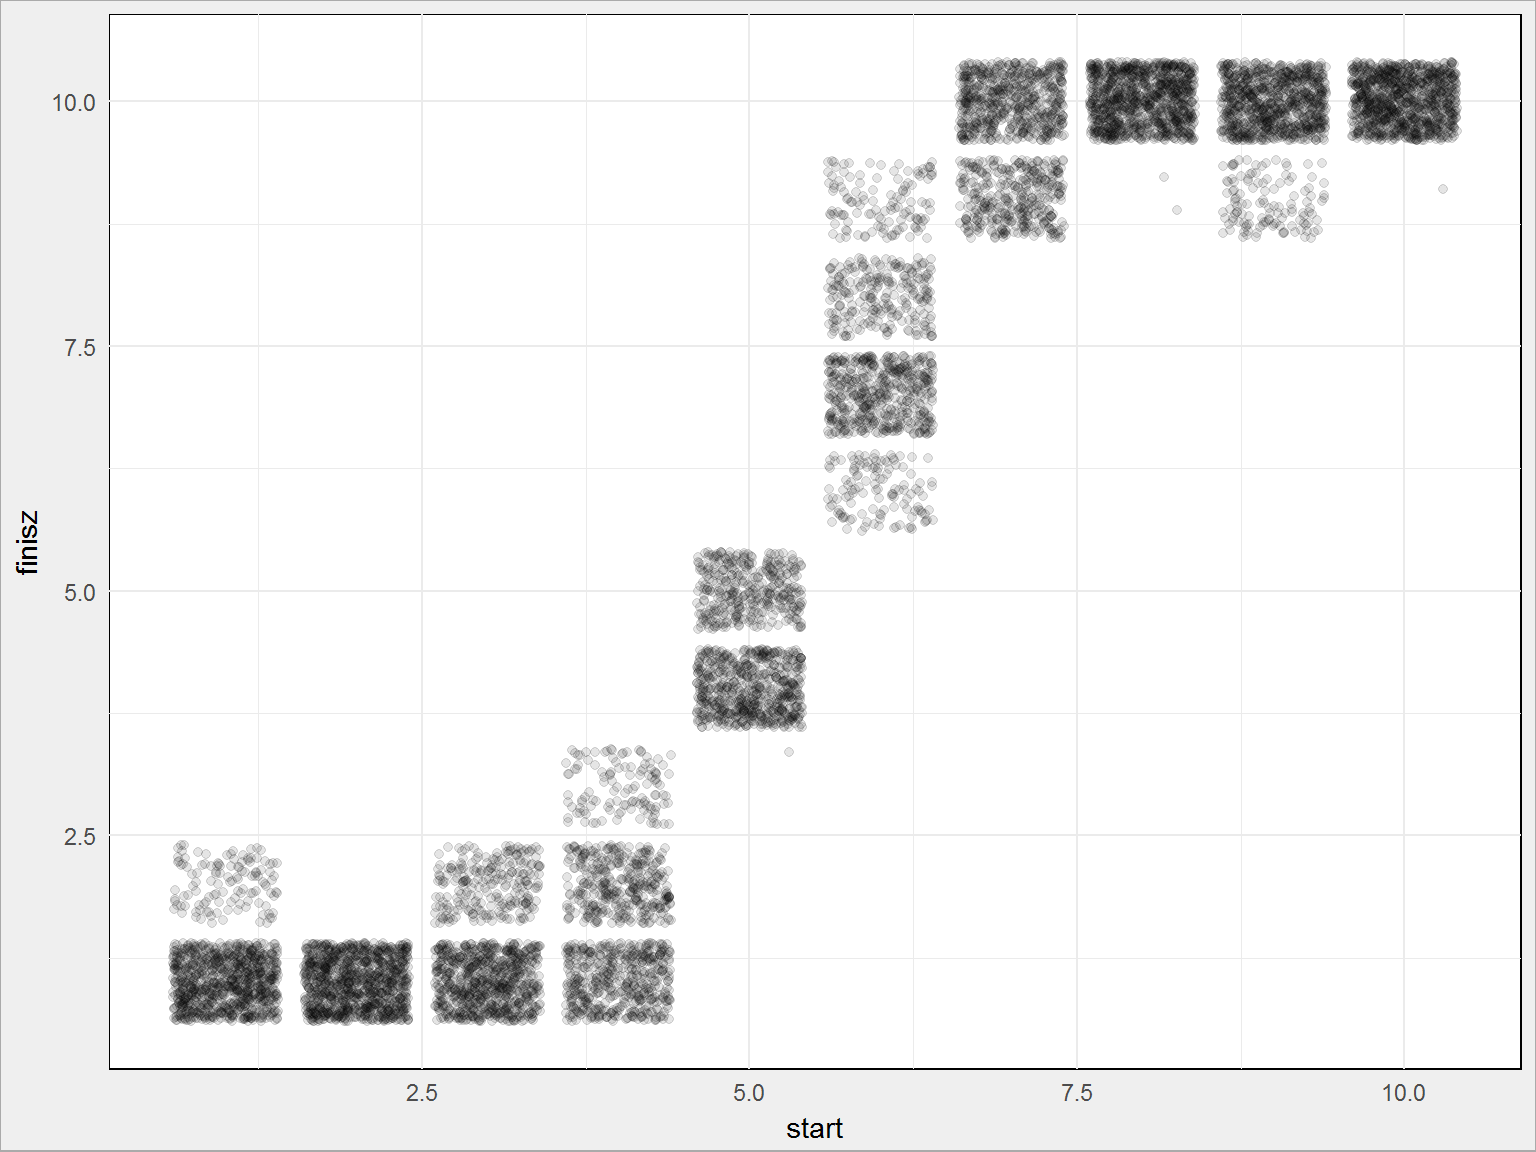 Widać coś, ale przeliczmy liczbę punktów na prawdopodobieństwo i nieco uporządkujmy sam wykres:
df %>%
   mutate(start = as.factor(start), finisz = as.factor(finisz)) %>%
   count(start, finisz) %>%
   ungroup() %>%
   group_by(start) %>%
   mutate(p = 100*n/sum(n)) %>%
   mutate(maks = n == max(n)) %>%
   ungroup() %>%
   ggplot() +
   geom_tile(aes(start, finisz, fill = n), color = "gray80", show.legend = FALSE) +
   geom_text(aes(start, finisz, label = sprintf("%.1f%%", p), size = maks), show.legend = FALSE) +
   scale_fill_gradient(low = "darkgreen", high = "yellow") +
   scale_size_manual(values = c("TRUE" = 5, "FALSE" = 3)) +
   labs(x = "Kolumna początkowa", y = "Kolumna końcowa")
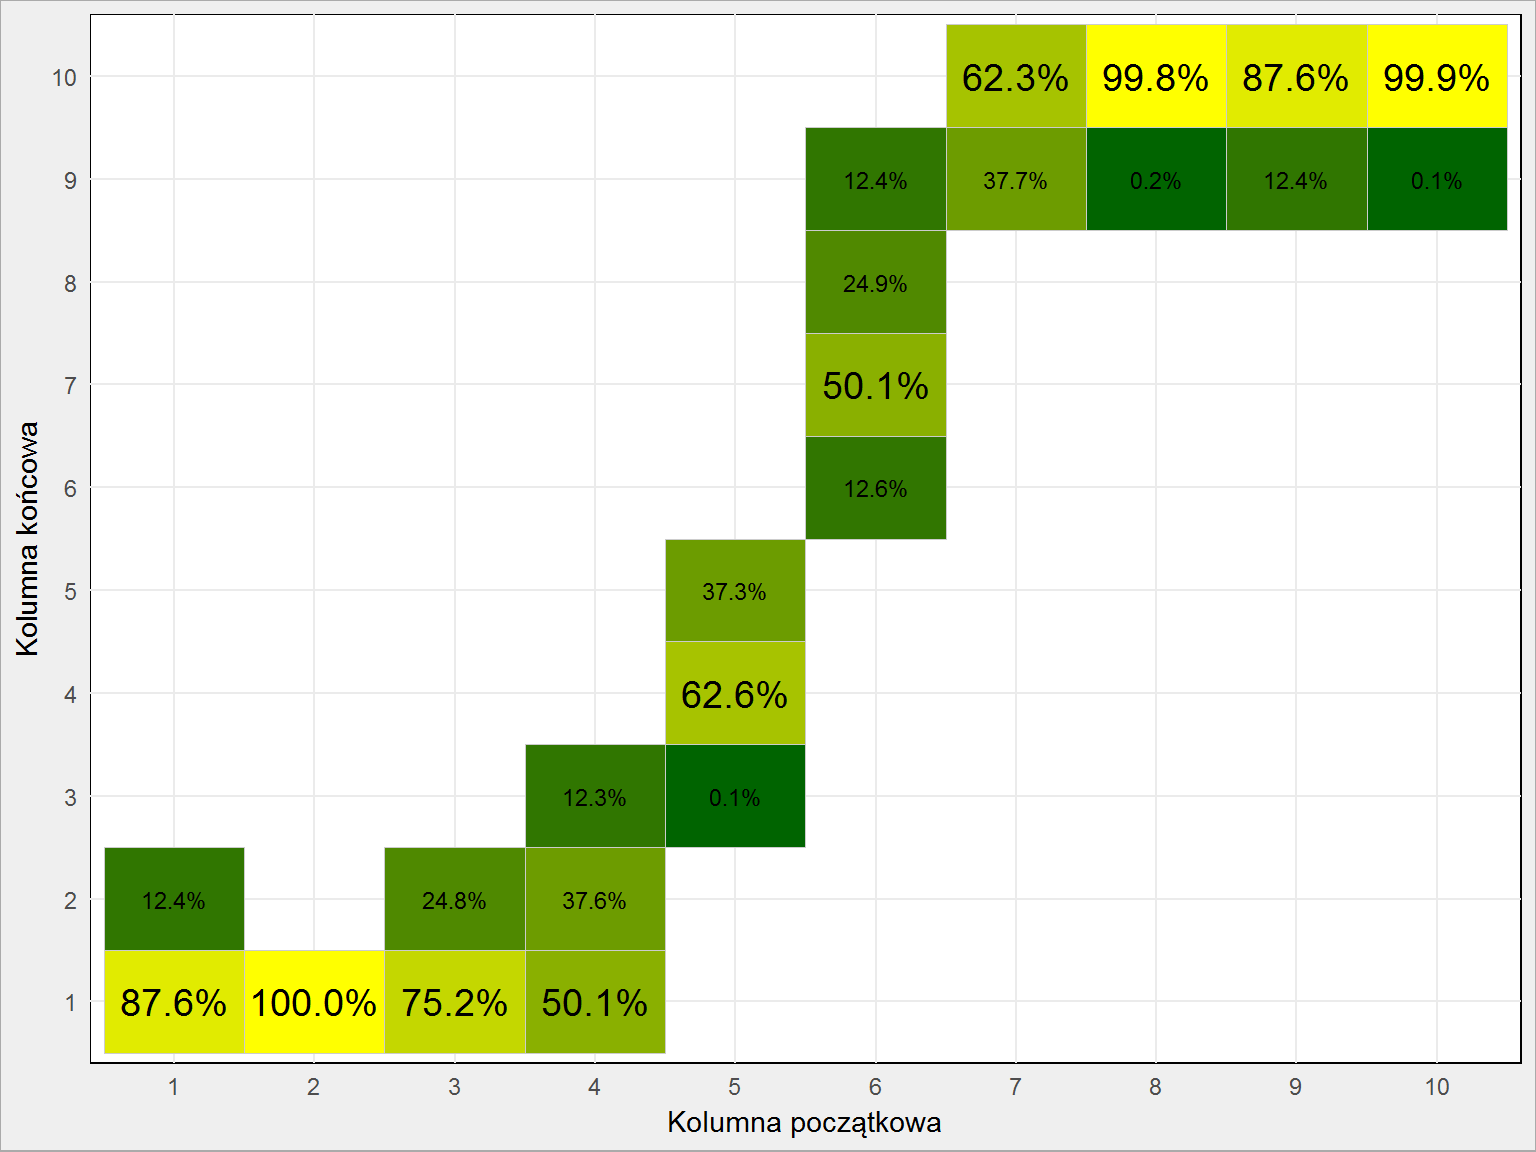 Prawdopodobieństwo liczone jest w pione powyższego wykresu. To znaczy, że upuszczając kulę z kolumny 4 w 50.1% przypadków wylądowała ona w kolumnie 1, w 37.6% w kolumnie 2, a w 12.3% - w kolumnie 3. Widać, że największy rozrzut jest dla kolumn środkowych. Prawie pewni możemy być, że puszczając kulkę z kolumn 2, 8 i 10 wylądujemy w kolumnach skrajnych (odpowiednio 1 i 10).
Przygotujmy jeszcze tabelę kolumna startowa - kolumna końcowa, która powinna graczom ułatwić wybór kolumn:
df %>%
   count(start, finisz) %>%
   ungroup() %>%
   group_by(start) %>%
   mutate(p = 100*n/sum(n)) %>%
   mutate(maks = n == max(n)) %>%
   ungroup() %>%
   filter(maks) %>%
   select(start, finisz)
| Kolumna startowa | Kolumna końcowa |
|---|---|
| 1 | 1 |
| 2 | 1 |
| 3 | 1 |
| 4 | 1 |
| 5 | 4 |
| 6 | 7 |
| 7 | 10 |
| 8 | 10 |
| 9 | 10 |
| 10 | 10 |
Można to uprościć do reguł:
- 1 wypadnie, kiedy zaczniemy od kolumn 1 do 4
- dla początkowej 5 wypadnie 4
- dla 6 wypadnie 7
- dla pozostałych (8-10) wypadnie 10
Teraz tylko wystarczy zobaczyć gdzie jest największa kasa (interesują nas w sumie tylko cztery kolumny: 1, 4, 7 i 10) i odpowiednio wypuścić kulkę. Oczywiście to gra losowa i przy jednej próbie nie musi wcale tak być. Dodatkowo ważny aspekt naszej symulacji: uprościliśmy tablicę do kwadratowej (w teleturnieju jest trapezem), uprościliśmy rozmieszczenie kołków odbijających kulę oraz uprościliśmy liczbę kolumn startowych do takiej samej dla każdej rundy (zdaje się, że w teleturnieju z każdą rundą zmienia się liczba kolumn z której może wypaść kula). Szukając materiałów o teleturnieju znalazłem podobną analizę na blogu, który może zainteresować fanów NBA (pod kątem analitycznym). Tam znajdziecie lepiej rozpoznaną planszę i więcej liczb (dlaczego autor nie zrobił z tego heatmapy? porównywanie liczb z czterema miejscami po przecinku to koszmar; mógł chociaż wyróżnić największe wartości w rzędzie w ostatniej tabeli…). Idea pozostaje jednak taka sama. W piątek pewnie obejrzę teleturniej jeszcze raz (powtórka jest bodaj w niedziele) - synowi starszemu strasznie te kule się podobają, a Was zachęcam do eksperymentów. Policzcie jaka jest oczekiwana wartość wygranej przy poprawnych odpowiedziach na wszystkie pytania.