
Pulp Fiction - analiza filmu
Jak dobrze znacie Pulp Fiction? Ja widziałem ten film chyba ze 20 razy. Ciekawe jak widzi go maszyna… Jeśli nie oglądaliście jakimś cudem filmu uprzedzam - poniżej są spoilery. Nawet maszyna je wychwyciła ;) Zajmiemy się analizą scenariusza. Podobnie jak było z twittami przy Oscarach - nie będziemy go czytać (no, prawie - do uporządkowania danych przyda się znajomość filmu - jak widać poniżej wskazuję konkretne linijki), pozwolimy na mechaniczną analizę. Na początek potrzebny będzie tekst scenariusza. Jest kilka serwisów, na których można znaleźć takie rzeczy, wczytajmy więc gotowy tekst. Potrzebujemy tekstu angielskiego - w drugiej części wpisu pokusimy się o analizę emocjonalną tekstu, a tutaj o polskie słowniki trudno. Trudno byłoby też pewnie znaleźć przetłumaczony scenariusz.
script <- readLines("http://dailyscript.com/scripts/pulp_fiction.html")
Najtrudniejszą (i najnudniejszą jednocześnie) pracą analityka jest czyszczenie danych. Trzeba je rozumieć, znać ich znaczenie i format, wiedzieć jak powinny wyglądać, a czasem naprawiać - coś usunąć albo dodać. Albo uśrednić. 3/4 czasu pracy analityka to takie za przeproszeniem rzeźbienie w wiadomo czym.
library(dplyr)

script <- script[-(1:6)]
script <- script[-(7594:7597)]
script <- data.frame(script=script, stringsAsFactors = FALSE)
script$scene <- NA
script$person <- NA
script$removeline <- FALSE

script <- filter(script, nchar(script) != 0)
Mamy “ramkę danych” z tekstem i przygotowanymi kolumnami na oznaczenie numeru sceny i bohatera wypowiadającego kwestię (to będziemy analizować w drugiej części). W scenariuszu są miejsca - przy czarnych planszach z nazwami rozdziałów - w których brakuje jasnej informacji (dla maszyny - dla osoby czytającej tekst jest to zrozumiałe) o rozpoczęciu nowej sceny. Musimy dodać to odpowiednio podmieniając wiersz tekstu.
script[921, "script"] <- "               INT. "
script[2548, "script"] <- "               INT. "
script[4005, "script"] <- "               INT. "
script[2407, "script"] <- "               INT. "
script[4490, "script"] <- ""
script[4491, "script"] <- ""
W Hollywood obowiązuje określony szablon scenariusza opisujący przede wszystkim lewe marginesy dla odpowiednich części tekstu. Dzięki temu pójdzie nam dość łatwo. Wiersz po wierszu “czytamy” scenariusz dodając odpowiednie znaczniki, całość sprowadza się do:
- oznaczenia linii niepotrzebnych (to co nie jest wypowiadaną kwestią)
- oznaczenia numerów scen
- oznaczenia postaci wypowiadających kwestie
- oczyszczenia skryptu z linii niepotrzebnych
scene_no <- 0
person <- ""
for(i in 1:nrow(script)) {
   # scena we wnętrzu
   if(substr(script[i, "script"], 1, 20) == "               INT. ")
   {
      scene_no <- scene_no + 1
      person <- ""
      script[i, "removeline"] <- TRUE
   }

   # scena na zewnątrz
   if(substr(script[i, "script"], 1, 20) == "               EXT. ")
   {
      scene_no <- scene_no + 1
      person <- ""
      script[i, "removeline"] <- TRUE
   }

   # didaskalia - zaczynają się właśnie tutaj
   # (zamiast ostatniej spacji jest jakiś znak)
   if(substr(script[i, "script"], 1, 16) != "                ")
      script[i, "removeline"] <- TRUE

   if(substr(script[i, "script"], 1, 30) == "                              ")
      script[i, "removeline"] <- TRUE

   # oznaczenie kto wypowie kwestię z następnego wiersza
   if(substr(script[i, "script"], 1, 37) == "                                     ")
   {
      person <- trimws(script[i, "script"])
      script[i, "removeline"] <- TRUE
   }

   script[i, "scene"] <- scene_no
   script[i, "person"] <- person
}
Odpowiednio oznakowany scenariusz czyścimy ze zbędnych linii:
script_clean <- script %>%
   filter(!removeline, scene!=0) %>%
   select(scene, person, script) %>%
   mutate(script=trimws(script))

# zapiski Mr.Wolfa ujęte są jak kwestie - usuwamy
script_clean <- script_clean[-c(2095,2096,2098), ]

# pozostałości w wycinaniu linii
script_clean <- script_clean %>%
   filter(!person %in% c("", "CUT TO:", "LANCE AND VINCENT"))
Lance i Vincent w kluczowym momencie z Mią i strzykawką krzyczą razem - jedna linijka tekstu, a zaburza później grafy ;) dlatego to wycinamy powyżej. Niektóre imiona pojawiają się dopiero w dalszych częściach sceny lub w kolejnych scenach, ale wiemy kto je wypowiada, więc możemy odpowiednio przypisać słowa Osoby, które mówią z offu zmieniamy na “normalne” wypowiedzi (bo to bez znaczenia czy z offu czy nie).
script_clean$person <- gsub(" (O.S.)", "",
                            script_clean$person, fixed = TRUE)
script_clean$person <- gsub(" (V.O.)", "",
                            script_clean$person, fixed = TRUE)

script_clean$person <- ifelse(script_clean$person=="YOUNG WOMAN",
                              "HONEY BUNNY", script_clean$person)
script_clean$person <- ifelse(script_clean$person=="YOUNG MAN",
                              "PUMPKIN", script_clean$person)
script_clean$person <- ifelse(script_clean$person=="(PAUSE)",
                              "BUTCH", script_clean$person)
script_clean$person <- ifelse(script_clean$person=="(TO JULES)",
                              "THE WOLF", script_clean$person)
script_clean$person <- ifelse(script_clean$person=="WOMAN'S VOICE",
                              "MOTHER", script_clean$person)
Scenariusz mamy oczyszczony i przygotowany do analizy. Na początek zobaczmy kto gra w której scenie?
t_graph <- script_clean %>%
   select(scene, person) %>%
   unique()
Skoro już to wiemy, to zobaczmy to:
library(ggplot2)
t_graph %>%
   ggplot() +
   geom_tile(aes(scene, person)) +
   theme_minimal()
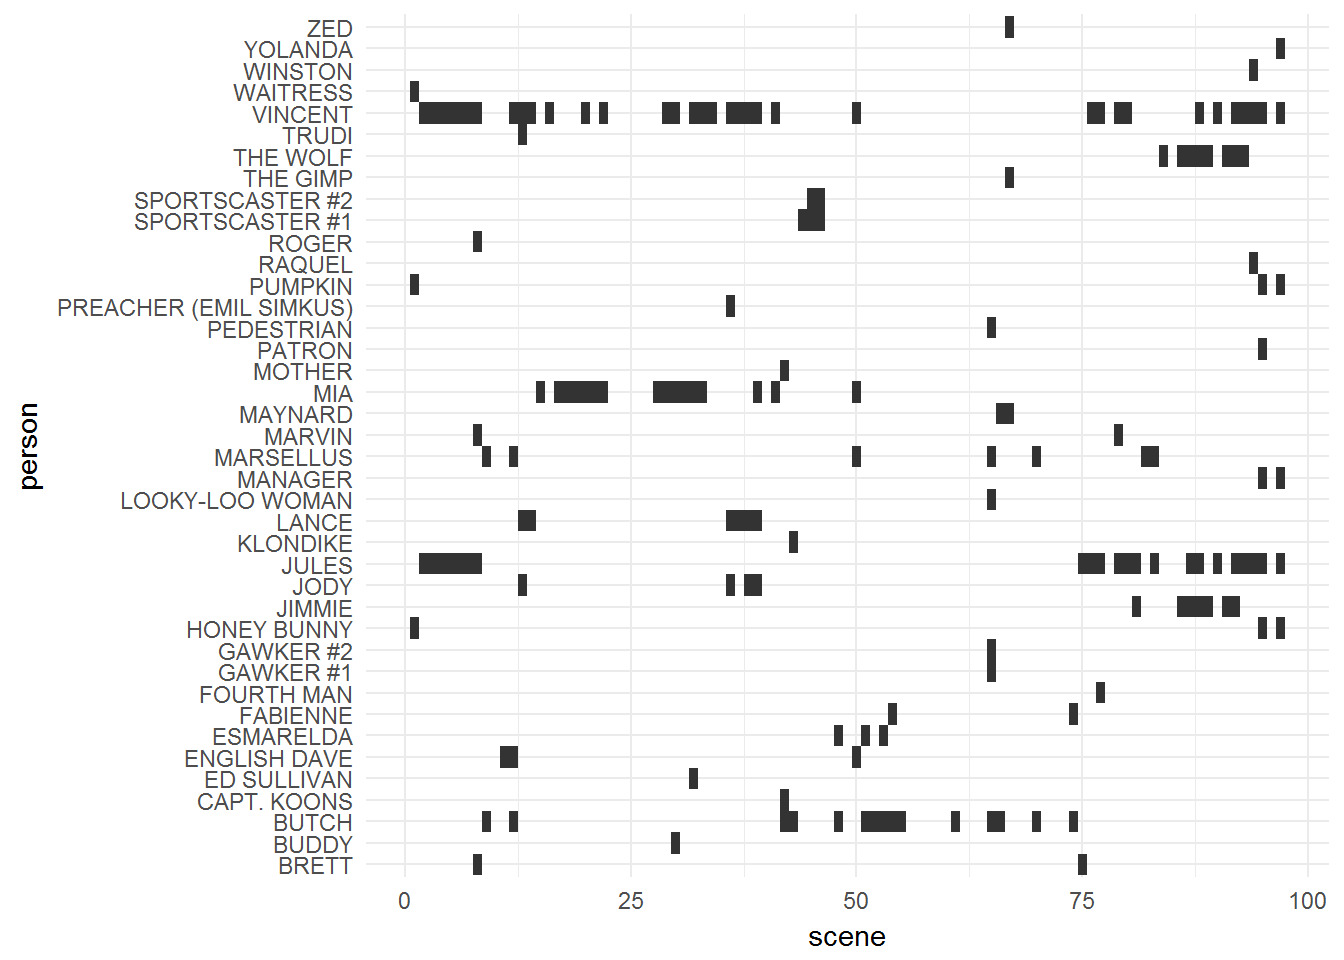 Widać tutaj kolejne bloki fabularne (wiem, bo znam film):
- Pumpkin i Honey Bunny w barze, scena otwierająca
- Vincent i Jules odwiedzają mieszkanie w poszukiwaniu walizki Marcellusa
- Vincent odwiedza Lance’a, kupuje co trzeba na wieczór
- Vincent spotyka się z Mią. Widać tutaj, że w scenach 23-27 nikt niczego nie mówi (można to sprawdzić w oryginalnym scenariuszu z oznaczonymi numerami scen - tabela script). To sekwencja przed wyjściem Mii i Vincenta do “Jack Rabbit Slim’s”
- Mia ląduje z Vincentem u Lance’a
- historia o zegarku (kapitan Koons)
- Butch, długo o nim - najpierw z Esmereldą, potem z Fabienne, potem potrącenie pieszego
- na chwilę wpada też Zed, na chwilę, z kolegami
- wracamy do mieszkania, żeby zobaczyć jak skończyły się odwiedziny Vincenta i Julesa, chwilę później już jesteśmy w mieszkaniu Jimmy’ego
- do mieszkania Jimmy’ego z pomocą przyjeżdża Mr. Wolf
- sprzątanie i na koniec trafiamy do baru z Pumpkin i Honey Bunny
A z kim wchodzi w interakcję? To widać już po tym gdzie postacie występują razem. Spróbujmy do tego podejść inaczej - budując graf. Grafy to bardzo ciekawe struktury, wykorzystywane w wielu dziedzinach. Dla niezaznajomionych z tematem - na początek Wikipedia. Na początek potrzebujemy tabeli gdzie dla każdej sceny będziemy mieć wszystkie pary osób w niej występujących.
t_graph <- left_join(t_graph, t_graph, by="scene") %>%
   filter(person.x!=person.y) %>%
   # A + B to to samo co B + A
   # musimy w rakie konieczności pozamieniać kolumny
   mutate(PersonA = if_else(person.x > person.y, person.x, person.y),
          PersonB = if_else(PersonA==person.x, person.y, person.x)) %>%
   select(scene, PersonA, PersonB) %>%
   unique()
Dalsza praca to biblioteka do manipulacji grafami - igraph. Zróbmy graf (nieskierowany - nie ma znaczenia kto do kogo mówi, a nawet jeśli - nie jesteśmy tego w stanie na poziomie suchego tekstu wychwycić maszynowo).
library(igraph)

g <- graph_from_data_frame(unique(select(t_graph, from=PersonA, to=PersonB)), directed = FALSE)
Zobaczmy jak ten graf wygląda (i co to w ogóle jest).
plot(g)
 Nie wygląda to za ciekawie. W sensie jest brzydkie. Spróbujmy jakoś wyróżnić wierzchołki grafu, trochę pozmieniać wielkość napisów.
Pozwolimy R zakwalifikować każdy z wierzchołków do jakiejś grupy i na tej podstawie go pokolorujemy. O szczegółach przypisania do grupy możecie doczytać w opracowaniach dotyczących teorii grafów.
V(g)$color_walktrap <- cluster_walktrap(g)$membership

plot(g,
     vertex.color=V(g)$color_walktrap,
     vertex.label.color="black",
     vertex.label.cex=0.7,
     edge.arrow.size=0)
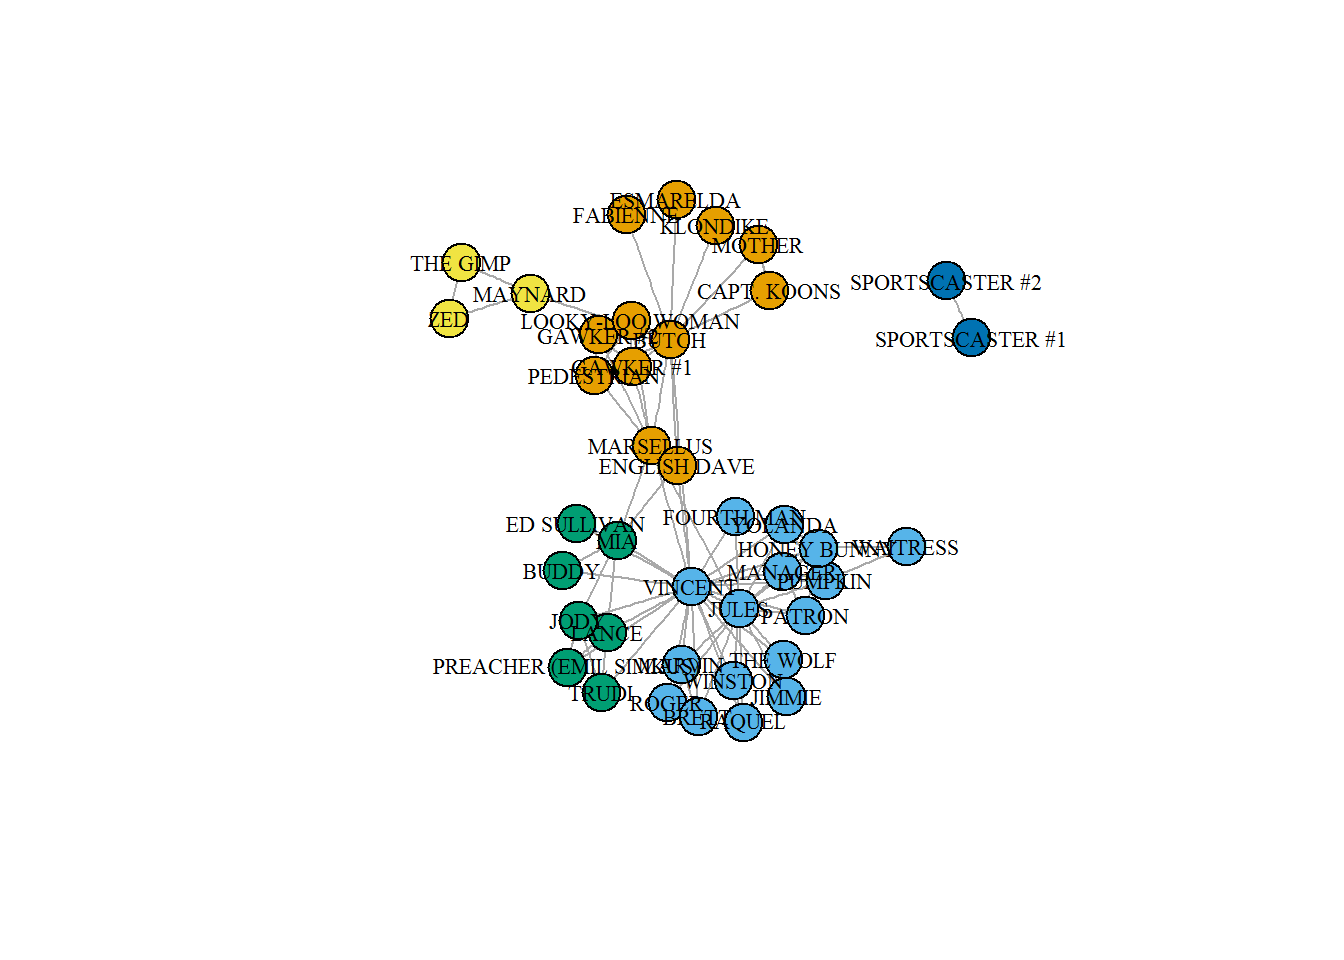 Co tutaj widać? W połączeniu z “planem występów” z poprzedniego wykresu mamy cały film. Graf wyraźniej pokazuje nam interakcje bohaterów między sobą. Spójrzmy na poszczególne grupy bohaterów.
Grupa pierwsza:
| group | person |
|---|---|
| 1 | BUTCH |
| 1 | MARSELLUS |
| 1 | ENGLISH DAVE |
| 1 | ESMARELDA |
| 1 | FABIENNE |
| 1 | MOTHER |
| 1 | CAPT. KOONS |
| 1 | KLONDIKE |
| 1 | PEDESTRIAN |
| 1 | GAWKER #1 |
| 1 | GAWKER #2 |
| 1 | LOOKY-LOO WOMAN |
Czyli to co dzieje się wokół Butcha. Jest Fabienne, jest Esmarelda (pani z taksówki), jest historia o zegarku. Wpadł też tutaj Marcellus, chociaż mógł równie dobrze wpaść do innej grupy. Ostatnie cztery osoby na powyższej liście to uczestnicy jednej sceny, która zmienia fabułę filmu (wypadek samochodowy) - Marcellus zauważa Butcha - i to widać na grafie: te osoby są połączeni z dwoma panami. Grupa druga:
| group | person |
|---|---|
| 2 | VINCENT |
| 2 | JULES |
| 2 | THE WOLF |
| 2 | JIMMIE |
| 2 | PUMPKIN |
| 2 | HONEY BUNNY |
| 2 | MARVIN |
| 2 | MANAGER |
| 2 | BRETT |
| 2 | WAITRESS |
| 2 | ROGER |
| 2 | WINSTON |
| 2 | RAQUEL |
| 2 | PATRON |
| 2 | YOLANDA |
| 2 | FOURTH MAN |
Vincent i Jules i wydarzenia z nimi związane. Panowie od walizki Marcellusa i kłopoty jakie z tego wniknęły (Mr. Wolf w mieszkaniu Jimmy’ego). A do tego Pumpkin i Honey Bunny, bo przecież ostatnia scena łączy ich z Vincentem i Julesem. Vincent mógł pojawić się w grupie z Butchem, ale potrzebowaliby zamienić ze sobą kilka słów, w kilku dodatkowych scenach. Grupa trzecia:
| group | person |
|---|---|
| 3 | MIA |
| 3 | LANCE |
| 3 | JODY |
| 3 | TRUDI |
| 3 | PREACHER (EMIL SIMKUS) |
| 3 | BUDDY |
| 3 | ED SULLIVAN |
Mia i jej przygody związane z towarem od Lance’a. Plus kelnerzy z Jackrabbit Slim’s. Grupa czwarta do której mógłby należeć także Marcellus i Butch to trójca:
| group | person |
|---|---|
| 4 | MAYNARD |
| 4 | ZED |
| 4 | THE GIMP |
Na grafie widać, że tych trzech panów łączy z Marcellusem postać Butcha. Na koniec pozostali, jako oddzielna grupa (widać na grafie, że nie wchodzą w interakcję z nikim innym) - sprawozdawcy sportowi słyszani w radio, w taksówce Esmareldy. Czas na analizę kwestii - o czym się mówi i jak się mówi? Najpierw rozdzielimy (bardzo wygodna biblioteka tidytext) wszystkie kwestie na bi-gramy, czyli dwuwyrazowe ciągi. Przykład takiego rozdzielenia to:
- dla zdania “Lubię oglądać filmy przyrodnicze” wszystkie bi-gramy to:
- lubię oglądać
- oglądać filmy
- filmy przyrodnicze
library(tidytext)
library(tidyr)
library(wordcloud)

# bi-grams
script_bigrams <- script_clean %>%
   unnest_tokens(bigrams, script, token="ngrams", n=2) %>%
   count(bigrams, sort = TRUE)

script_bigrams_sep <- script_clean %>%
   unnest_tokens(bigrams, script, token="ngrams", n=2) %>%
   separate(bigrams, c("word1", "word2"), sep=" ") %>%
   count(word1, word2, sort= TRUE)

script_bigrams_sep_fil <- script_bigrams_sep %>%
   filter(!word1 %in% stop_words$word) %>%
   filter(!word2 %in% stop_words$word) %>%
   unite(bigram, word1, word2, sep=" ")
co tu się wydarzyło? Rozdzieliliśmy kwestie na bi-gramy. Później każdy z bi-gramów na pojedyncze słowa, żeby odfiltrować (słowo pierwsze i drugie z osobna) śmieci, tak zwane stop words (bibliotek tidytext zawiera ich 728) - słowa, które nie niosą żadnych emocji. Po odfiltrowaniu łączymy to co zostało. Tak wyglądają najpopularniejsze (najczęściej występujące) słowa wypowiadane w Pulp Fiction:
require(RColorBrewer)
pal <- brewer.pal(8,"Dark2")

wordcloud(script_bigrams_sep_fil$bigram,
          script_bigrams_sep_fil$n,
          scale=c(3,.1),
          colors = pal)
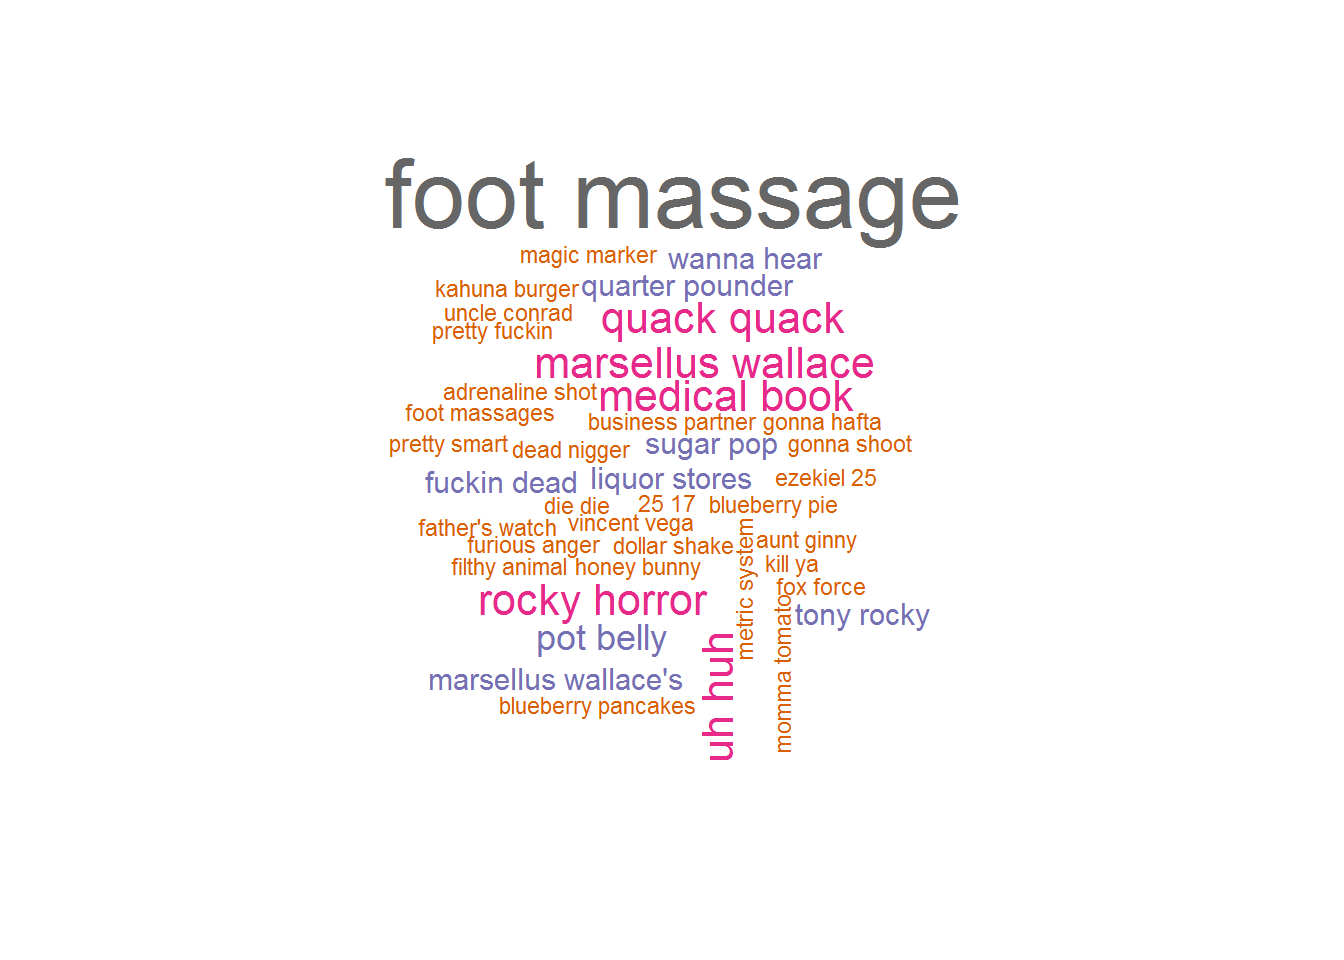 Bez filtrowania stop words dostajemy masę nieistotnych śmieci:
wordcloud(script_bigrams$bigrams,
          script_bigrams$n,
          scale=c(3,.1),
          colors = pal)
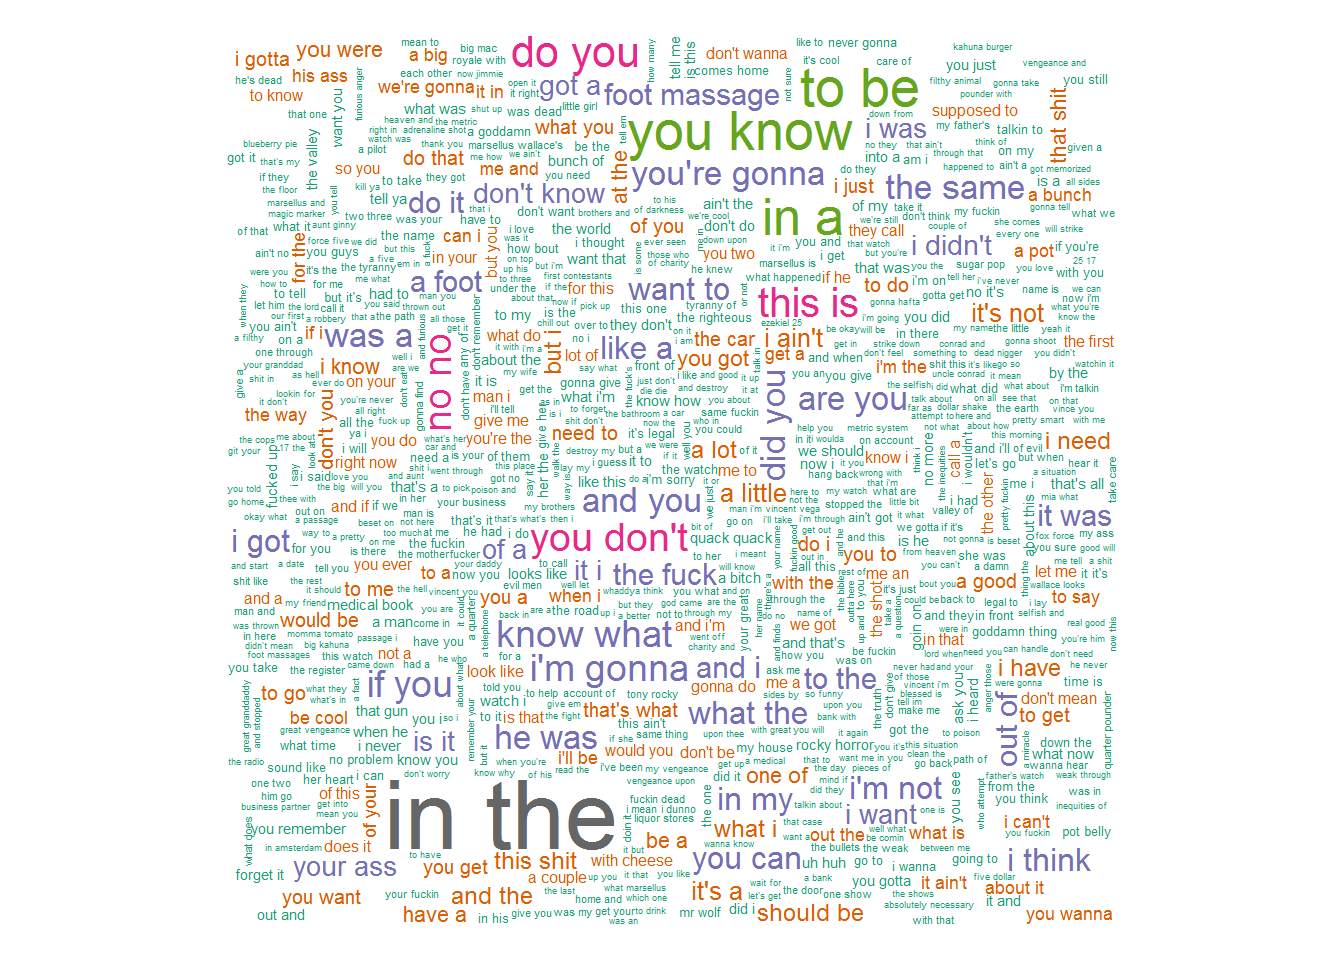 Zobaczmy jeszcze nasze bigramy (te odfiltrowane) w innym układzie, dość standardowym.
script_bigrams_sep_fil %>%
   top_n(20, n) %>%
   mutate(bigram=factor(bigram, levels=bigram)) %>%
   ggplot() +
   geom_bar(aes(bigram, n), stat="identity") +
   theme_minimal() +
   theme(axis.text.x = element_text(angle=90))
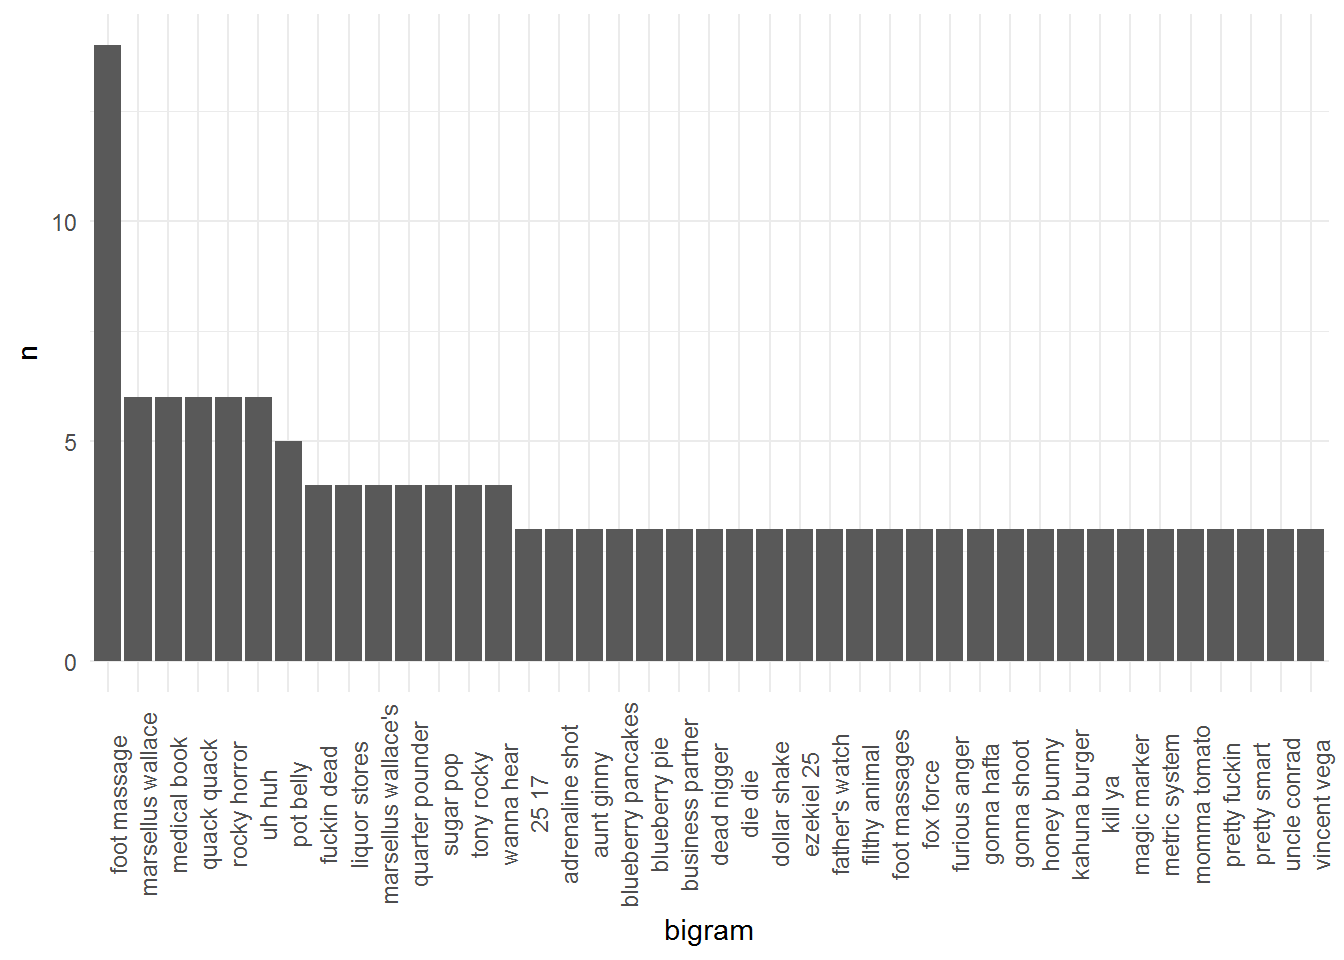 Królem (tutaj to widać wyraźniej) jest “foot massage”. Wszystko przez jedną, monotematyczną scenę. Widać też kluczowe kwestie tego filmu: “adrenaline shot”, “marsellus wallace” czy też “dead nigger” albo “fuckin’ dead”.
Sprawdźmy z ciekawości tri-gramy:
# tri-grams
script_trigrams <- script_clean %>%
   unnest_tokens(trigrams, script, token="ngrams", n=3) %>%
   count(trigrams, sort = TRUE)

script_trigrams_sep <- script_clean %>%
   unnest_tokens(trigrams, script, token="ngrams", n=3) %>%
   separate(trigrams, c("word1", "word2", "word3"), sep=" ") %>%
   count(word1, word2, word3, sort= TRUE)

script_trigrams_sep_fil <- script_trigrams_sep %>%
   filter(!word1 %in% stop_words$word) %>%
   filter(!word2 %in% stop_words$word) %>%
   filter(!word3 %in% stop_words$word) %>%
   unite(trigram, word1, word2, word3, sep=" ")
wordcloud(script_trigrams_sep_fil$trigram,
          script_trigrams_sep_fil$n,
          scale=c(3,.2),
          colors = pal)
 Ezekiel 25:17. To wszystko. Reszta przypadkowo.
script_trigrams_sep_fil %>%
   filter(n > 1) %>%
   mutate(trigram=factor(trigram, levels=trigram)) %>%
   ggplot() +
   geom_bar(aes(trigram, n), stat="identity") +
   theme_minimal() +
   theme(axis.text.x = element_text(angle=90))
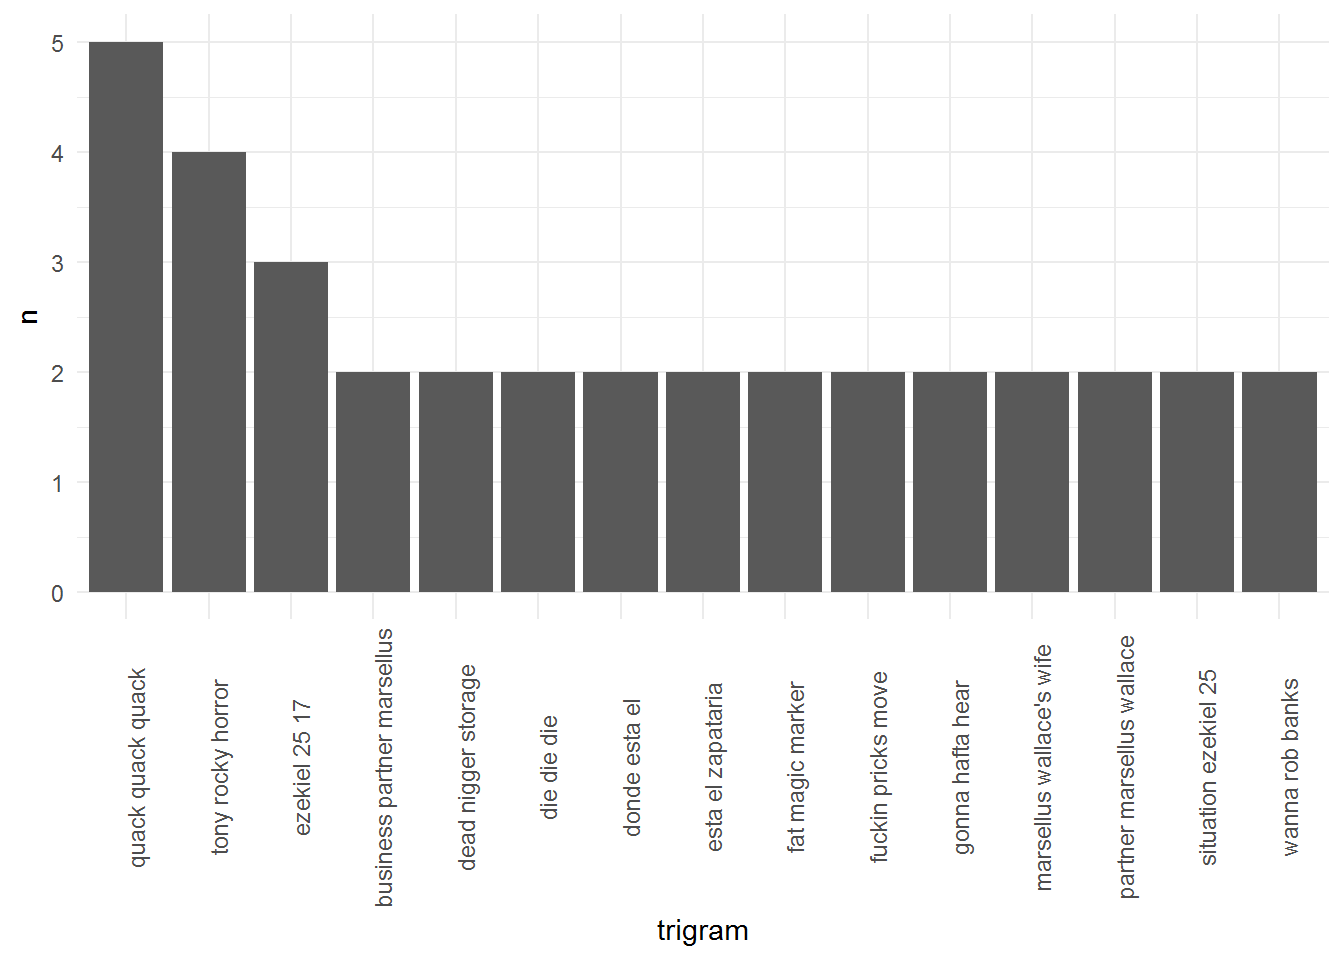 A najpopularniejsze pojedyncze słowa? Na ich podstawie policzymy coś ciekawego.
# words
script_words <- script_clean %>%
   unnest_tokens(word, script) %>%
   count(word, sort = TRUE) %>%
   filter(!word %in% stop_words$word)
wordcloud(script_words$word,
          script_words$n,
          scale=c(3,.3),
          colors = pal)
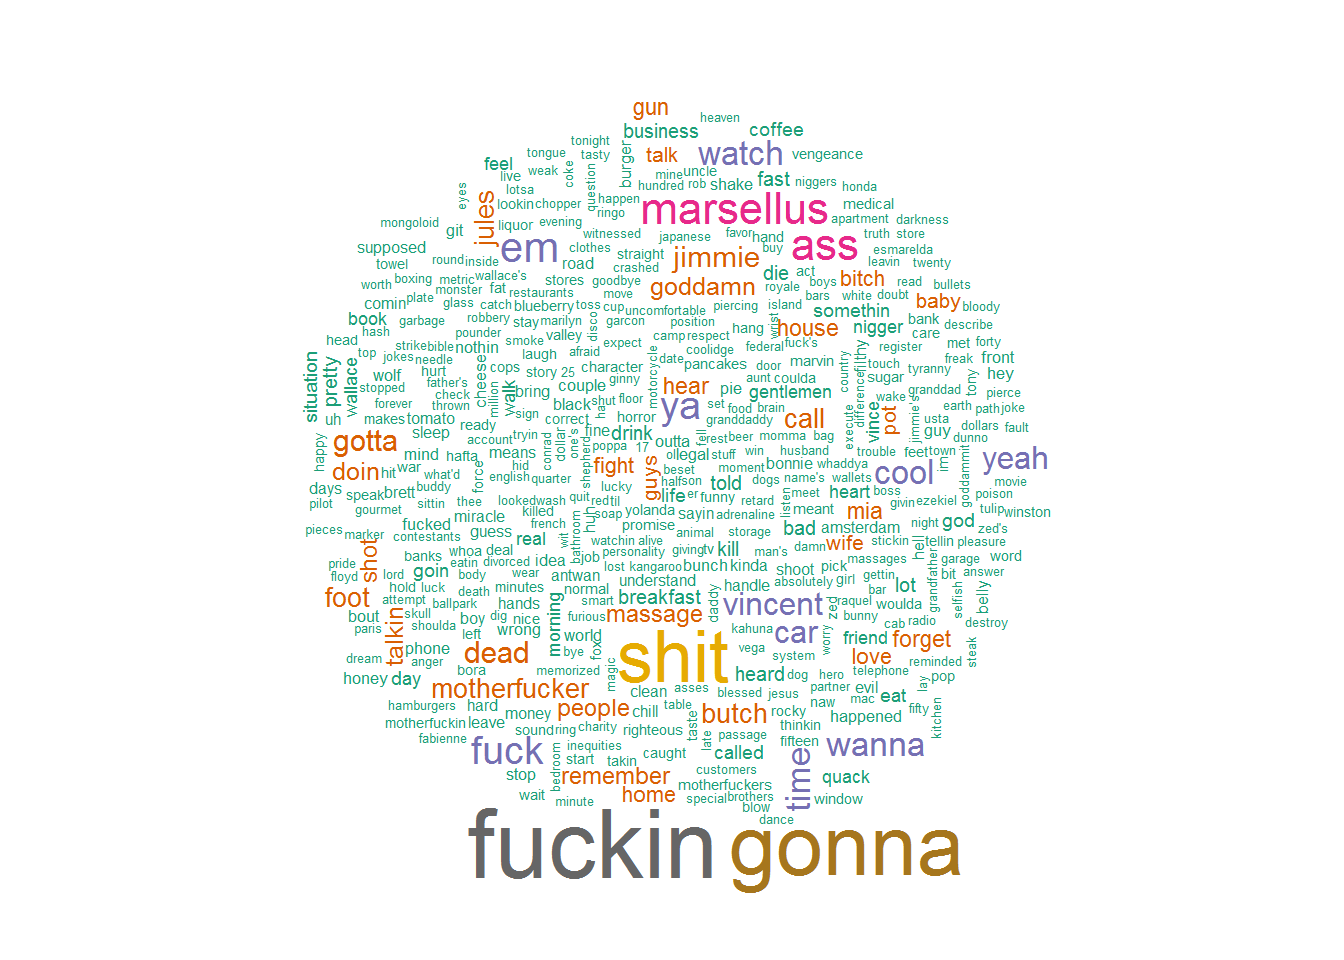 Fuck, shit, ass, dead. No ten film raczej nie jest pozytywny, prawda? Tak przynajmniej wynika z używanego słownictwa.
Kurt****Vonnegut wygłosił kiedyś pewien wykład, o tym że wszystkie historie mają jakiś charakterystyczny przebieg. Sami zobaczcie:Podzielmy scenariusz na pojedyncze (tylko znaczące - bez stop words) słowa:
# sentiment in time
script_sentiment <- script_clean %>%
   unnest_tokens(word, script) %>%
   filter(!word %in% stop_words$word)
Teraz spróbujmy narysować to, o czym mówi Vonnegut. Każdemu ze słów przypiszmy sentiment czyli wartość liczbową opisującą ładunek emocji. Ujemną dla słów negatywnych, dodatnią dla pozytywnych.
script_sentiment %>%
   inner_join(get_sentiments("afinn"), by="word") %>%
   group_by(scene) %>%
   summarise(sentiment=mean(score)) %>%
   ungroup() %>%
   mutate(col=ifelse(sentiment>=0, "positive", "negative")) %>%
   ggplot() +
   geom_bar(aes(scene, sentiment, fill=col),
            stat="identity",
            show.legend = FALSE) +
   scale_fill_manual(values=c("positive"="green",
                              "negative"="red")) +
   theme_minimal()
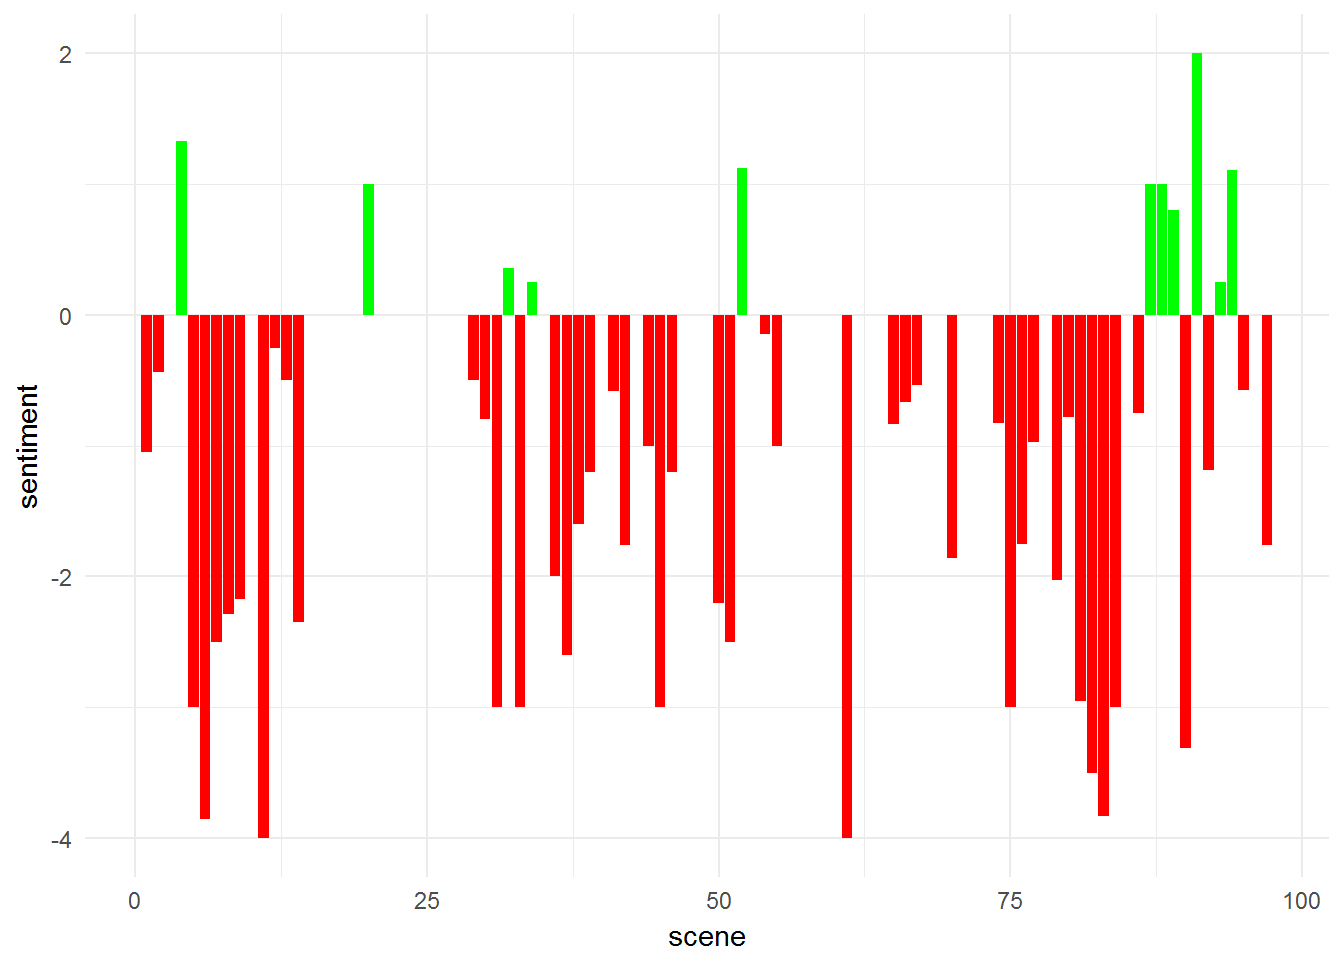 Krwawo jest. Albo inaczej - nie jest miło. Język Pulp Fiction jest nieprzyjazny, raczej pesymistyczny.
Są jednak wyjątki - poszukajmy ich.
| scene | sentiment |
|---|---|
| 4 | 1.333333 |
| 20 | 1.000000 |
| 32 | 0.360000 |
| 34 | 0.250000 |
| 52 | 1.125000 |
| 87 | 1.000000 |
| 88 | 1.000000 |
| 89 | 0.800000 |
| 91 | 2.000000 |
| 93 | 0.250000 |
| 94 | 1.111111 |
Najbardziej “pozytywna” scena to według analizy scena 91:
INT. CHEVY NOVA – MORNING

The interior of the car has been cleaned and lined with
bedspreads and quilts. Believe it or not, what looked like a
portable slaughterhouse can actually pass for a non-descript
vehicle.

The Wolf circles the car examining it.

Jules and Vincent stand aside, their clothes are literally a
bloody mess, but they do have a sense of pride in what a
good job they've done.

                      THE WOLF
          Fine job, gentlemen. We may get out
          of this yet.

                      JIMMIE
          I can't believe that's the same car.

                      THE WOLF
          Well, let's not start suckin' each
          other's dicks quite yet. Phase one
          is complete, clean the car, which
          moves us right along to phase two,
          clean you two.
Powód tak “pozytywnej” oceny to słowa (te, które zostały po oczyszczeniu i mają przypisaną wartość emocjonalną):
| person | word | score |
|---|---|---|
| THE WOLF | fine | 2 |
| THE WOLF | clean | 2 |
| THE WOLF | clean | 2 |
Jak widać słów zostało mało i to same pozytywne. Niestety to jest ułomność tej metody. Można próbować analizować całe zdania zamiast pojedynczych słów. Są narzędzia, które na to pozwalają.
Sprawdźmy jak zmienił się sentiment dla kwestii wypowiadanych przez jedną postać na przestrzeni filmu. Na przykład Mia Wallace:
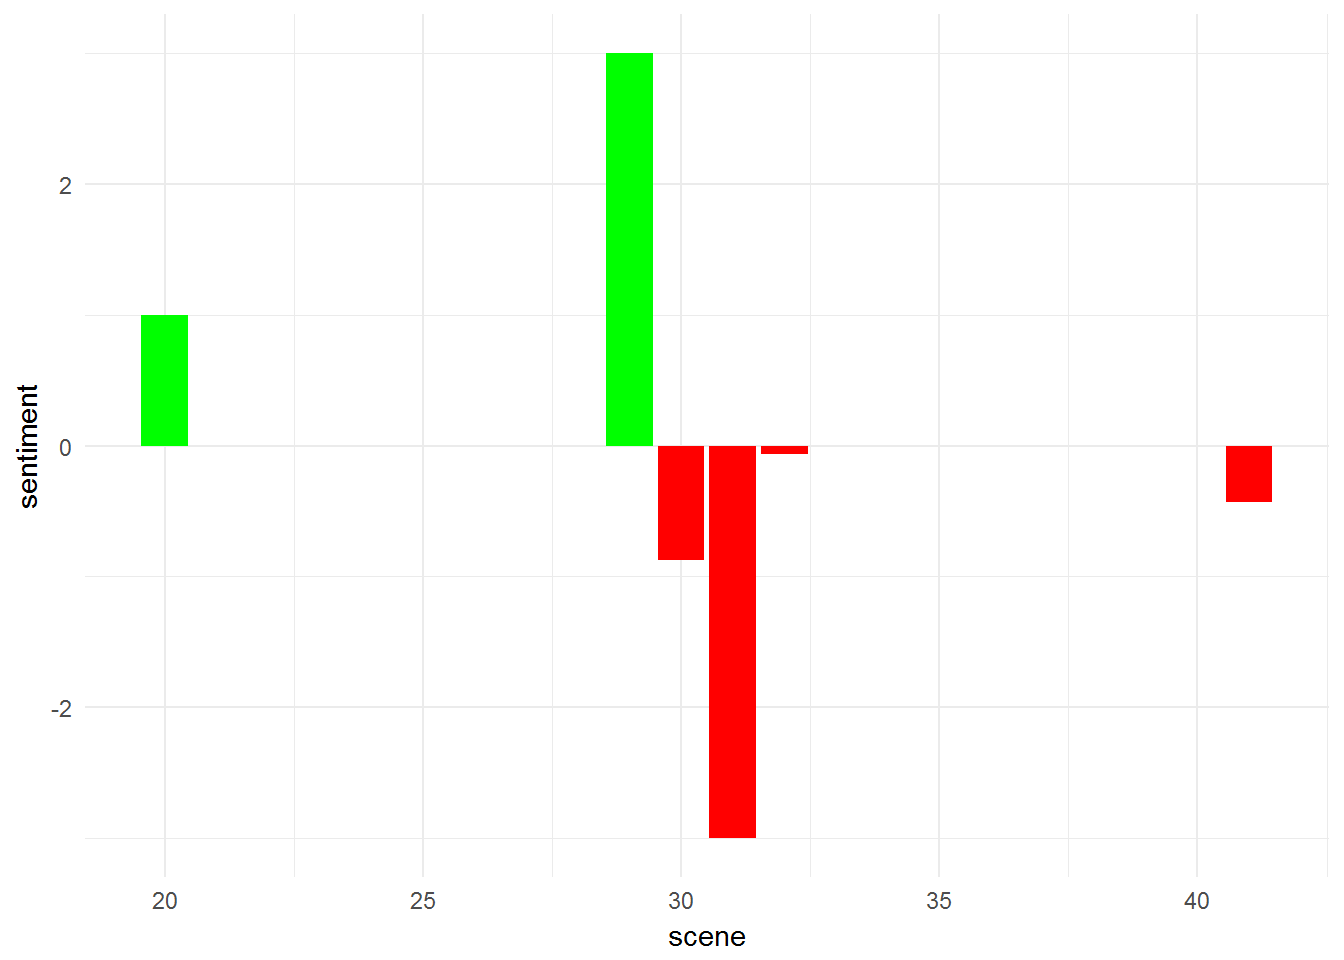 Wszystko było dobrze do sceny 29 (wówczas było nalepiej). To scena w Jackrabbit Slim’s. Z analizy wynika, że Mia używa całej masy niepotrzebnych słów poza jednym (z maksymalną wartością emocji pozytywnych) - love. Robi wynik.
W scenie 32 Mia używa mniej więcej w równym stopniu słów pozytywnych i negatywnych, ale negatywne są “silniejsze”: killing, worse, boring (w porównaniu do pretty, smart, win).
Na koniec jeszcze jedna rzecz - kto jest tym dobrym, a kto tym złym? Czy da się to określić na podstawie wypowiadanych kwestii? Użyjemy też analizy pojedynczych słów, ale skorzystamy z innego słownika (NRC zamiast AFINN) do opisania emocji poszczególnych słów. Słownik ten zamiast pojedynczej wartości zwraca wartość określającą jak bardzo słowo pasuje do jednej z kategorii (emocji).
script_sentiment <- script_sentiment %>%
   inner_join(get_sentiments("nrc"), by="word") %>%
   group_by(person, sentiment) %>%
   count() %>%
   ungroup() %>%
   group_by(person) %>%
   mutate(m=n==max(n))
script_sentiment %>%
   ungroup() %>%
   filter(n>10) %>%
   ggplot() +
   geom_point(aes(sentiment, person, size=n, color=m),
              show.legend = FALSE) +
   labs(x="", y="") +
   theme_minimal()
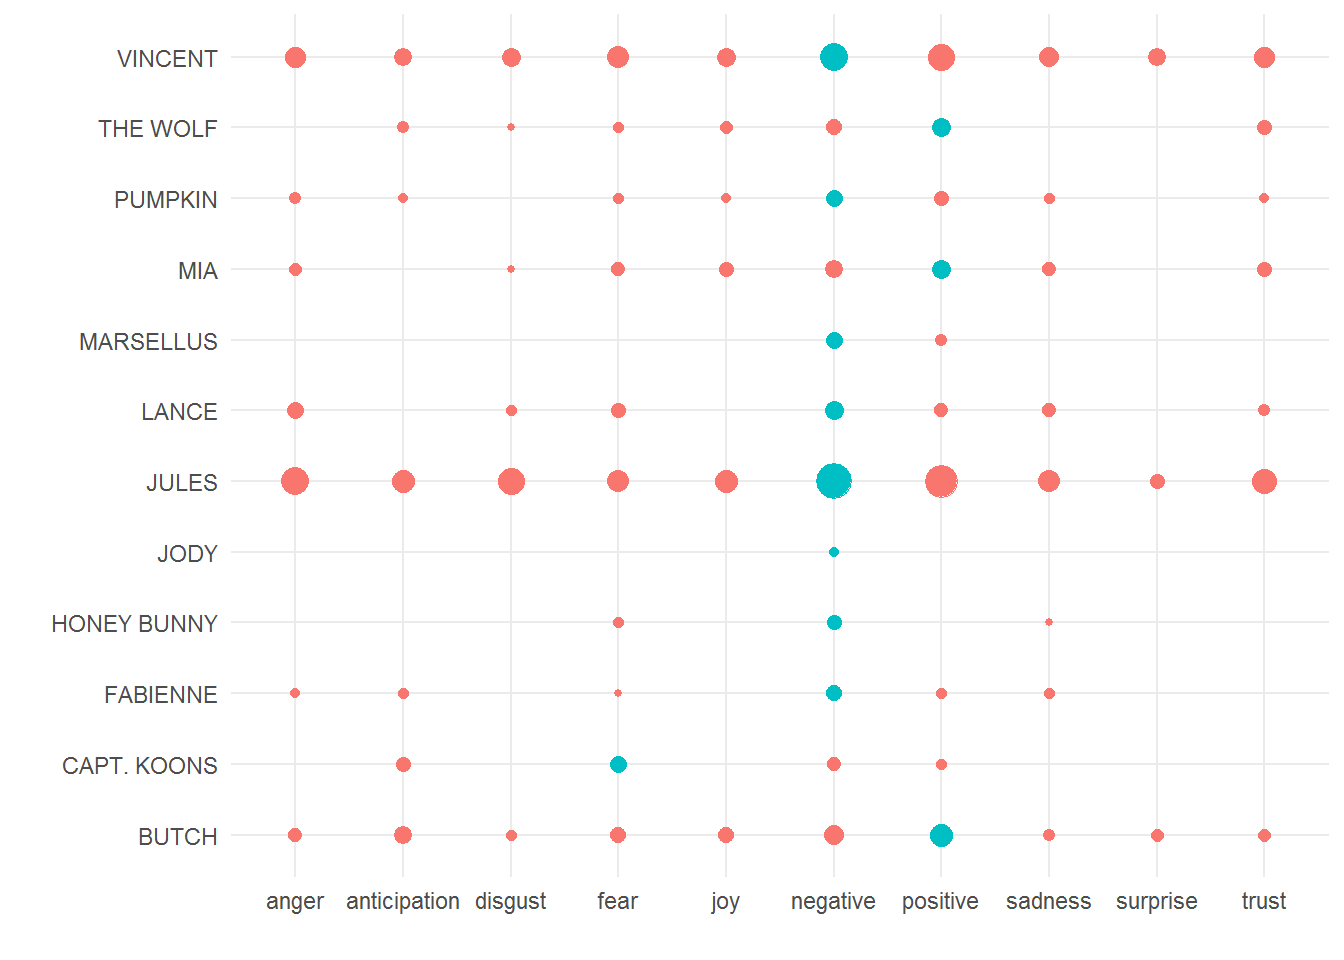 Jak widać wszyscy są negatywni. Mówią brzydko, bo to oznacza “są negatywni”. Taki urok filmów Tarantino.
Zobaczmy dokładnie, kto pasuje do której emocji - po uśrenieniu całego filmu:
script_sentiment %>%
   filter(m, n>4) %>%
   select(person, sentiment) %>%
   arrange(desc(sentiment))
Otrzymujemy listę tych pozytywnych, negatywnych i strasznych:
- positive
- BUTCH
- MIA
- THE WOLF
- WINSTON
- negative
- BUDDY
- ESMARELDA
- FABIENNE
- HONEY BUNNY
- JIMMIE
- JODY
- JULES
- ANCE
- MARSELLUS
- MAYNARD
- PUMPKIN
- VINCENT
- fear
- CAPT. KOONS
Opowieść o zegarku jest według takiej metody straszna. No trochę jest. Wpis te powstał po inspiracji popularnym (przy tego typu zagadnieniach) poście o analizie “Love Actually”. Wczoraj zaś znalazłem świeżutką, analogiczną analizę wszystkich części “Władcy Pierścieni”. Polecam.