
Grudniowe dzieci
Czy zastanawialiście się w jakim miesiącu najczęściej bywacie na urodzinowych imprezach? Wtedy, kiedy mają te urodziny, prawda? A kiedy mają? Wtedy, kiedy rodzi się najwięcej dzieci, czyż nie? Sprawdźmy to - korzystając z danych GUS oraz stosunkowo prostego skryptu w języku R. Na początku potrzebne będzie kilka bibliotek do wygodnego przetwarzania danych. Jeśli nie masz ich - zainstaluj.
- tidyverse - to biblioteka wywołująca inne biblioteki, taki skrót. My będziemy potrzebować konkretnie dplyr (do szybkich operacji na danych) oraz ggplot2 (do rysowania wykresów)
- XLConnect - jedna z wielu pozwalająca na czytanie arkuszy Excela (dane GUS są zapisane w tej formie), ja lubię ją najbardziej (jest wygodna w użyciu). Uwaga - wymaga Javy
- reshape2 - kolejna do manipulacji danymi, w tym przypadku do będzie potrzebna do rozpivotowania danych (funkcja melt())
- lubridate - do transformacji dat
Po ewentualnej instalacji (poprzez install.packages()) możemy załadować biblioteki do R:
library(tidyverse)
library(XLConnect)
library(reshape2)
library(lubridate)
Mamy narzędzia, czas na przygotowanie danych. Są na stronach GUS (dane za lata 2002-2015), wszystkie w plikach Excela, na szczęście nazywają się w ujednolicony sposób. Po chwili poszukiwania udało mi się uzyskać bezpośrednie linki do danych, niestety spakowanych w pliki ZIP. Można dobrać się do nich ręcznie (klikając po stronie, zapisując, rozpakowując), ale chyba wygodniej kazać to zrobić maszynie, prawda? Najpierw pobierzmy i rozpakujmy wszystkie pliki, kolejno dla każdego roku:
for(rok in 2002:2015) {
   url <- paste0("http://demografia.stat.gov.pl/bazademografia/Downloader.aspx?file=pl_uro_", rok, "_00_7.zip&sys=uro")
   download.file(url, paste0("plik_", rok, ".zip"), mode = "wb")
   unzip(paste0("plik_", rok, ".zip"))
}
Teraz czas wydobyć dane z Excela. Po otwarciu pierwszego z kraju pliku widać układ danych. Kilka wierszy nagłówka i opisu, jakieś kolumny dodatkowe z sumami, interesujące nas dane zawsze w pierwszym arkuszu pliku. Pobierzmy z plików dla kolejnych lat surowe dane, zbijmy je do jednej tabeli.
urodzenia <- data.frame()
for(rok in 2002:2015) {
   plik <- paste0("pl_uro_", rok, "_00_7.xls")
   xls <- loadWorkbook(plik)
   df <- readWorksheet(xls,
                       sheet = 1,
                       startRow = 10, startCol = 3,
                       endRow = 41, endCol = 14)
   colnames(df) <- month.name
   df <- cbind(day=1:31, year=rok, df)
   urodzenia <- rbind(urodzenia, df)
}
Ciekawostka powyżej - kolumny z danymi nazywamy angielskimi nazwami miesięcy (zmienna month.name). Można by od razu tutaj nadać polskie nazwy miesięcy, ale wówczas funkcja ymd() z pakietu lubridate sobie nie poradzi z przekształceniem ciągu tekstowego w datę. Przed obróbką danych posprzątajmy jeszcze po sobie pliki tymczasowe (ściągnięte z GUS i wypakowane z ZIPów):
file.remove(paste0("pl_uro_", 2002:2015, "_00_7.xls"))
file.remove(paste0("plik_", 2002:2015, ".zip"))
Teraz czas na oczyszczenie danych. I ułożenie ich w formie wygodnej dla pakietu ggplot. Najpierw rozpiwotowanie czyli zamiana kolumn na wiersze. W drugim kroku usuwamy nieistniejące dni miesiąca (np. 30 luty).
urodzenia <- urodzenia %>%
   melt(id.vars = c("year", "day")) %>%
   filter(value!="-")
Teraz nazywamy kolumny dla wygody i przekształcamy dane, kolejno:
- tekst na liczby (liczba urodzin w danym dniu)
- datę z ciągu na wartość zrozumiałą dla komputera (po to były angielskie nazwy miesięcy)
- z daty wyciągamy informację o dniu tygodnia, a następnie nadajemy im polskie nazwy
- angielskie nazwy miesięcy przekładamy na polskie
- przy okazji dla dni tygodnia i miesięcy robimy z nich faktory - dzięki temu na wykresach będą we właściwej kolejności
colnames(urodzenia) <- c("year", "day", "month", "births")
urodzenia <- urodzenia %>%
   mutate(births = as.numeric(births)) %>%
   mutate(wday = wday(ymd(paste0(year,"-",month,"-",day)))) %>%
   mutate(wday = factor(wday,
                        levels = c(2, 3, 4, 5, 6, 7, 1),
                        labels = c("pn", "wt", "śr",
                                   "cz", "pt", "sb", "nd"))) %>%
   mutate(month = factor(month,
                          levels = month.name,
                          labels = c("Sty", "Lut", "Mar",
                                     "Kwi", "Maj", "Cze",
                                     "Lip", "Sie", "Wrz",
                                     "Paz", "Lis", "Gru")))
Mamy komplet danych, ładnie poukładanych. Jakie było pytanie? W którym miesiącu (średnio) rodzi się najwięcej dzieci? Tak. No to zobaczmy - pogrupujmy dane po miesiącach i policzmy średnią. Będzie to średnia dzienna urodzeń w danym miesiącu.
urodzenia %>%
   group_by(month) %>%
   summarise(births=mean(births)) %>%
   ungroup() %>%
   ggplot() +
   geom_bar(aes(month, births, fill=month),
            stat="identity",
            show.legend = FALSE) +
   theme_minimal()
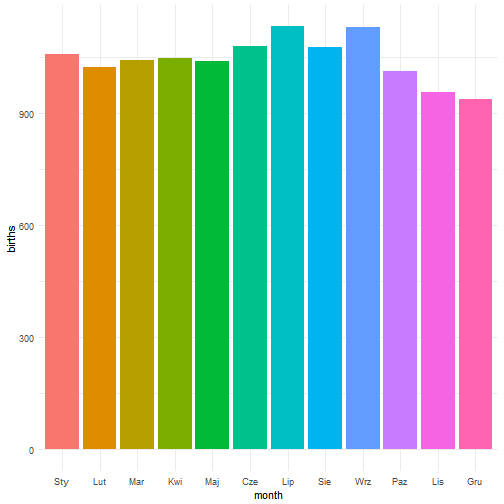 Na pierwszy rzut oka będzie to wrzesień i lipiec. W grudniu najmniej. Do konkretnej daty jeszcze dojdziemy. I do ciekawych wniosków, które wprost wynikają z danych.
Najpierw sprawdźmy w jakie dni tygodnia (znowu - średnio!) rodzą się dzieci?
urodzenia %>%
   group_by(wday) %>%
   summarise(births=mean(births)) %>%
   ungroup() %>%
   ggplot() +
   geom_bar(aes(wday, births, fill=wday),
            stat="identity",
            show.legend = FALSE) +
   theme_minimal()
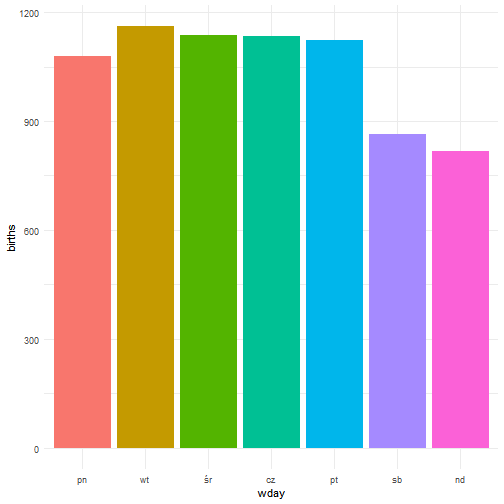 W “dni robocze”. W weekendy na porodówkach jest (nieco) spokojniej.
Kolejny krok to spojrzenie na cały kalendarz. Może na początek dla jakiegoś wybranego roku, powiedzmy 2011? Czerwony kolor to więcej urodzin, zielony - mniej.
urodzenia %>%
   filter(year==2011) %>%
   ggplot() +
   geom_tile(aes(month, day, fill=births),
             show.legend = FALSE,
             color="gray") +
   scale_y_reverse() +
   scale_fill_gradient(low="green", high="red") +
   theme_minimal()
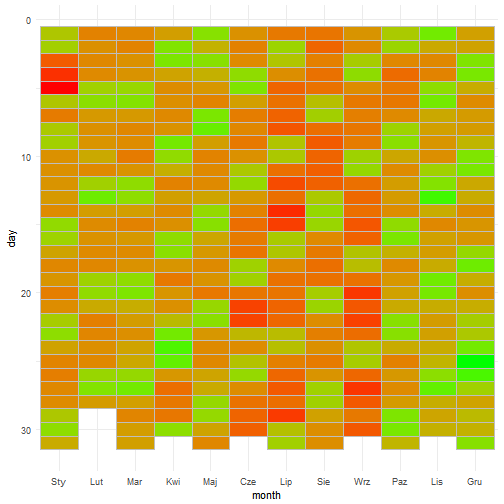 Więcej czerwonego jest - zgodnie z wnioskami z “wykresu miesięcznego” - w lipcu i wrześniu. Zielone rozkładają się cyklicznie - to weekendy.
Na wykresie dla jednego roku widać weekendy. Ale w latach 2002-2015 weekendy przesuwały się, sprawdźmy więc jak wygląda taka heatmapa dla wszystkich danych.
urodzenia %>%
   group_by(month, day) %>%
   summarise(births=mean(births)) %>%
   ungroup() %>%
   ggplot() +
   geom_tile(aes(month, day, fill=births),
             show.legend = FALSE,
             color="gray") +
   scale_y_reverse() +
   scale_fill_gradient(low="green", high="red") +
   theme_minimal()
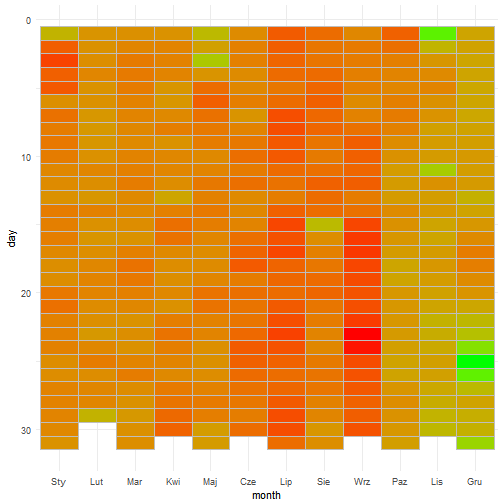 Widać po raz kolejny potwierdzenie tezy o zwiększonej liczbie dzieci urodzonych we wrześniu i lipcu. Wrzesień jest nawet bardziej “czerwony”. Widać też, że grudzień obfituje w najmniej urodzin, szczególnie w okolicy Bożego Narodzenia.
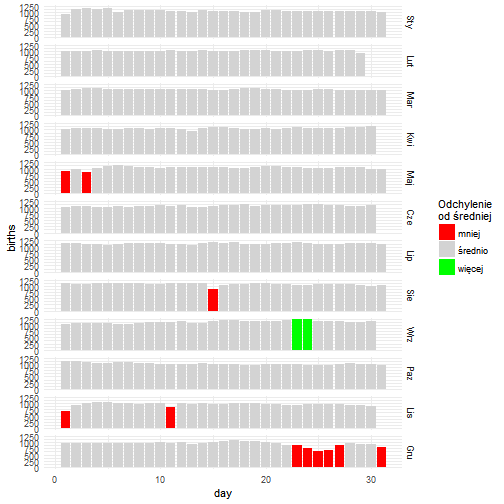
Sprawdźmy więc szczegółowo. W których dniach rodzi się więcej dzieci niż średnio i analogicznie - mniej? Za punkt odcięcia niech posłuży odchylenie standardowe od średniej (\sigma).
Zgodnie ze statystyką (w rozkładzie normalnym) 95,5% przypadków leży w przedziale (\pm 2\sigma) wokół średniej.
Policzmy więc średnią (mean()) i odchylenie standardowe (\sigma) (sd() w R) dla wszystkich dni, a następnie oznaczmy - już bezpośrednio na wykresie - te dni, które odbiegają od średniej.
urodzenia %>%
   group_by(month, day) %>%
   summarise(births=mean(births)) %>%
   ungroup() %>%
   mutate(m=mean(births), sd=sd(births)) %>%
   ggplot() +
   geom_bar(aes(day, births, fill=ifelse(births<(m-2*sd),
                                         "mniej",
                                         ifelse(births>(m+2*sd),
                                                "więcej",
                                                "średnio"))),
            stat="identity") +
   labs(fill="Odchylenie\nod średniej") +
   scale_fill_manual(values=c("mniej"="red",
                              "więcej"="green",
                              "średnio"="lightgray")) +
   facet_grid(month~.) +
   theme_minimal()
 I jeszcze to samo w innym układzie:
urodzenia %>%
   group_by(month, day) %>%
   summarise(births=mean(births)) %>%
   ungroup() %>%
   mutate(m=mean(births), sd=sd(births)) %>%
   ggplot() +
   geom_tile(aes(month, day, fill=ifelse(births<(m-2*sd),
                                         "mniej",
                                         ifelse(births>(m+2*sd),
                                                "więcej",
                                                "średnio"))),
             color="gray") +
   labs(fill="Odchylenie\nod średniej") +
   scale_fill_manual(values=c("mniej"="red",
                              "więcej"="green",
                              "średnio"="lightgray")) +
   scale_y_reverse() +
   theme_minimal()
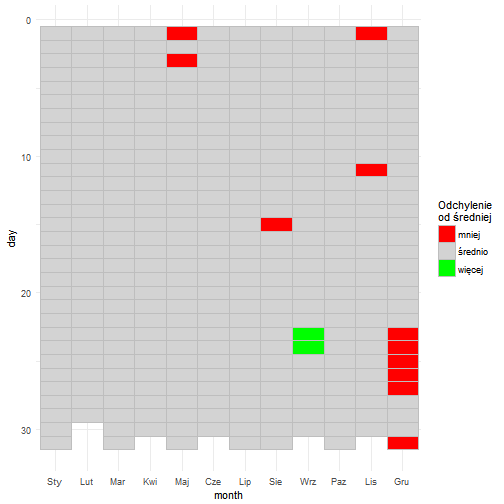 To co tutaj widać jest z jednej strony zaskakujące (no, trochę), z drugiej - do przewidzenia.
Już wcześniej zaobserwowaliśmy, że w okolicy Bożego Narodzenia rodzi się mniej dzieci, podobnie w weekendy. Tak jakby niemowlaki w czasie wolnym nie chciały się pchać na świat. I widać to też tutaj - czerwone punkty to dni wolne od pracy (lub ich okolice).
Jakie konkretnie? A, sprawdźmy (niech komputer policzy, co się będziemy męczyć sami).
Najpierw “czerwone” minima, razem ze średnią urodzin (z lat 2002-2015) w danym dniu:
urodzenia %>%
   group_by(month, day) %>%
   summarise(births=mean(births)) %>%
   ungroup() %>%
   mutate(m=mean(births), sd=sd(births)) %>%
   filter(births<(m-2*sd)) %>%
   arrange(births) %>%
   select(day, month, births)
| day | month | births |
|---|---|---|
| 25 | Gru | 649.7143 |
| 1 | Lis | 697.0000 |
| 26 | Gru | 701.8571 |
| 24 | Gru | 757.0714 |
| 31 | Gru | 800.1429 |
| 11 | Lis | 832.8571 |
| 3 | Maj | 846.5714 |
| 23 | Gru | 872.8571 |
| 15 | Sie | 890.0714 |
| 27 | Gru | 892.8571 |
| 1 | Maj | 893.2857 |
I co my tutaj mamy? Boże Narodzenie z przyległościami, dni wolne w listopadzie (1 i 11) oraz dni wolne w maju (1 i 3). Do tego dochodzi jeszcze 15 sierpnia. Zauważyliście, że dwa punkty były mocno zielone? To jest dopiero ciekawe, obiecuję! Które to dni?
urodzenia %>%
   group_by(month, day) %>%
   summarise(births=mean(births)) %>%
   ungroup() %>%
   mutate(m=mean(births), sd=sd(births)) %>%
   filter(births>(m+2*sd)) %>%
   arrange(desc(births)) %>%
   select(day, month, births)
| day | month | births |
|---|---|---|
| 23 | Wrz | 1225.643 |
| 24 | Wrz | 1219.571 |
A co takiego szczególnego jest w dniu 23/24 września? Ja nie wiem. Nie wiedziałem w tym miejscu. Ale pomyślałem. Ciąża trwa 280 (\pm) 14 dni, tak więc poczęcie miało miejsce…
ymd("2015-09-23") - ddays(280+14)
ymd("2015-09-23") - ddays(280-14)
…pomiędzy 2014-12-03 a 2014-12-31. Rok tutaj nie ma znaczenia - wstawiłem 2015 żeby jakoś odjąć daty. Czyli w grudniu. Stąd tytuł tego posta :) Gdyby założyć, że jednak większość dzieci rodzi się w 38 tygodniu ciąży (czyli w tym minimalnym, a już uznawanym za normalny i zdrowy termin rozwiązania), to znaczy w dokładnie 266 dni od poczęcia otrzymamy datę 2014-12-31. Wszystko jasne. Szaleństwa Sylwestrowej Nocy ;-). Ostatni wniosek jest nieco naciągany. Chociaż może raczej niezweryfikowany. Pewnie są odpowiednie dane (rozkład liczby urodzin w zależności od tygodnia ciąży). Potwierdzenie (lub nie) tezy “szalonego sylwestra” to już zadanie dla Was.